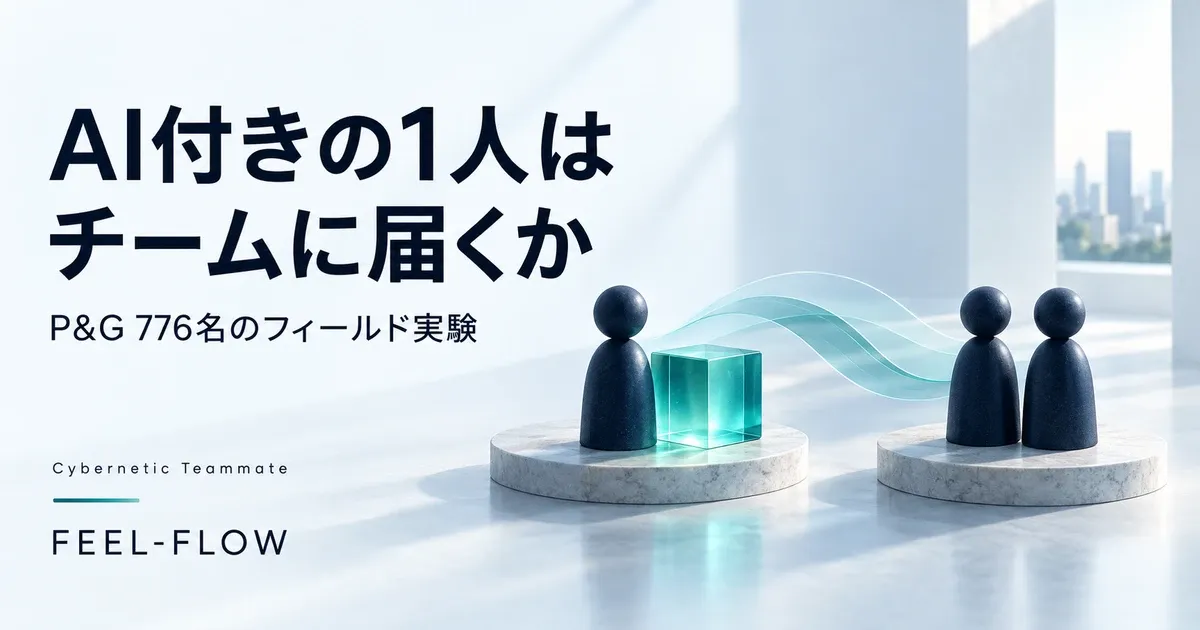
論文レポート生成AIAI付きの1人はチーム1組に届くか — P&G 776名フィールド実験「Cybernetic Teammate」要旨でP&Gの社員776名と報告された実験を、個人とチーム、AIの有無の4条件で読み解きます。AIを使った個人の成果物は、AIなしの2人チームと同程度の品質でした。一方、上位10%の解を出す確率はAI付きチームだけが有意に上がりました。平均を取るか、卓越を取るか。チーム編成の判断材料を整理します。分析岡崎 太公開日2026年10月2日出典数出典 3件
論文レポート生成AI専門家の成果物と「同等以上」は何割か — 44職種1,320タスク GDPval が示す実務委任ラインOpenAIのGDPvalは、44職種の専門家が作った実務タスクで、AIの成果物を専門家の成果物と比べる評価です。2025年9月の論文では、最良モデルでも専門家と同等以上は47.6%。その後半年ほどで80%台の自社公表値が並びました。数字の意味と限界を整理し、どの業務をどこまで任せるかの線引きに使います。分析岡崎 太公開日2026年9月30日出典数出典 5件
論文レポート生成AI読んだ文書がAIへの指示に変わる — AgentDojoの97タスク・629テストから考える導入前チェック外部文書を読んで業務を実行するAIを、何で評価すればよいのか。AgentDojoの97タスク・629セキュリティテストケースとOWASP 2025版を手がかりに、業務の達成・不正操作・人の承認を分けて点検する方法を考えます。分析岡崎 太公開日2026年9月24日出典数出典 2件
論文レポート生成AI任せたい業務と、AIができる業務は違う — WORKBankで考える導入順序AIで実行できそうでも、現場が任せたいとは限りません。StanfordのWORKBankは、米国の1,500人・104職種・844タスクを対象に、働く人の希望と専門家の能力評価を照合しました。自動化希望と技術的な見込みを分け、導入順序と人が担う範囲を決める方法を整理します。分析岡崎 太公開日2026年9月15日出典数出典 2件
論文レポート生成AIAIは数週間規模の開発タスクを完遂できるか — METRの時間軸(time horizon)研究とMirrorCode初期結果から読む「委任範囲」の動きMirrorCodeの4月初期結果では、Claude Opus 4.6が約16,000行のgotreeを再実装し、2,001テスト中2,000件に合格。6〜7月の完全版では25対象・最強モデル56%へ拡張され、Opus 4.7がgotreeを14時間・251ドルで再実装しました。初期値と完全版を分け、AIへ任せる条件を整理します。分析岡崎 太公開日2026年8月28日出典数出典 7件
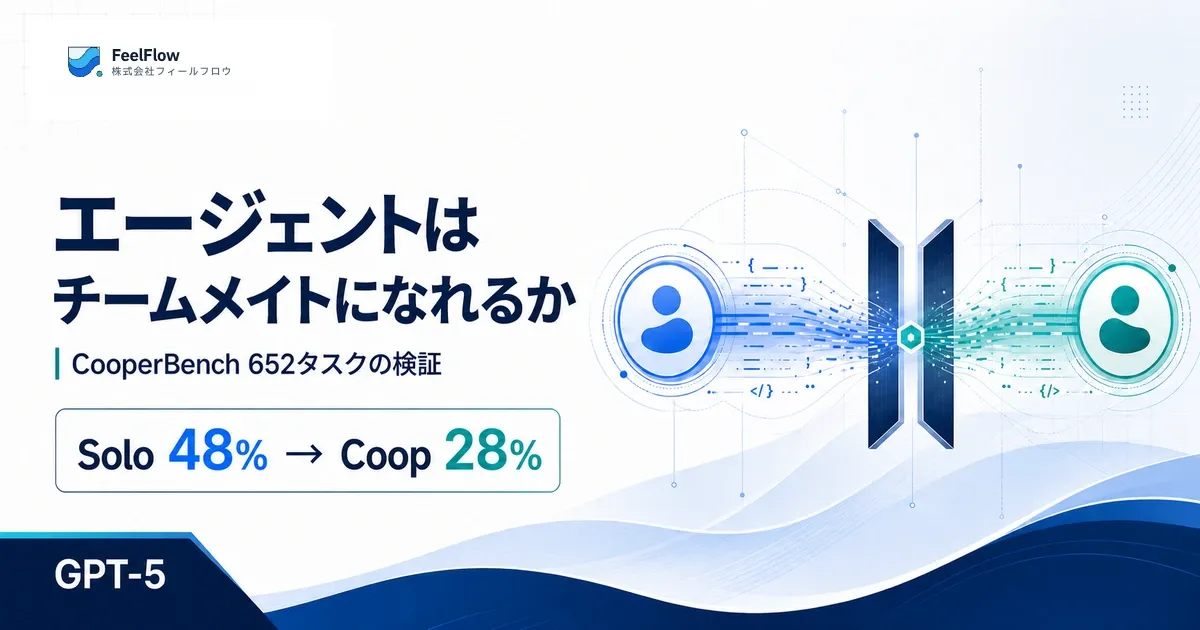
論文レポートAIエージェントエージェントは「チームメイト」になれるか — 652タスクで観測された「協調の呪い」、CooperBench を読むStanfordとSAP LabsのCooperBenchは、652の協調コーディングタスクで、2体のエージェントが1体より低い成功率になる「協調の呪い」を観測しました。SoloとCoopの比較、46タスクの人数拡張実験、失敗トレース分析を分けて読み、人間が設計すべき分担・計画・統合ゲートを整理します。分析岡崎 太公開日2026年8月27日出典数出典 2件
論文レポートAIエージェントコンサル・銀行・弁護士の実務タスクでAIエージェントはどこまでできるか — APEX-Agents が示す「任せられる粒度」の現在地投資銀行アナリスト・経営コンサルタント・企業弁護士の実務経験者が作った480の長時間クロスアプリタスクで、8種のAIエージェントを評価したベンチマーク APEX-Agents(Mercor、2026年1月公開)を読み解きます。一発成功率は論文の評価時点で最高24.0%。この数字を「仕事が代替されるか」ではなく「どの粒度なら任せられるか」の地図として読み、業務の切り出し方に落とし込みます。分析岡崎 太公開日2026年8月20日出典数出典 3件
論文レポートAIエージェントAIエージェントは実際「何に」使われているのか — 17.7万MCPツールの実証分析が示す「語られる未来」と「作られている現在」AIエージェントは営業も人事も変えると語られますが、公開MCPツールの実測データは別の姿を示します。17万7,436件を分析した英AIセキュリティ研究所の論文をもとに、公開ツールの67%がソフトウェア開発向けという現在地と、環境を直接変更する「アクション型」へのシフトを読み解き、自社のエージェント導入領域の選び方に落とし込みます。分析岡崎 太公開日2026年8月18日出典数出典 3件
論文レポート生成AI自己申告とRCTはなぜずれるのか — METR調査の「価値1.4〜2倍」と熟練OSS開発者の「完了時間19%増」METRの349名調査では、AIツールによる仕事の価値変化は自己申告で中央値1.4〜2倍。しかしMETR自身が「この数字には懐疑的になる理由がある」と注記しています。同じMETRのRCTでは、経験豊富なOSS開発者はAI利用で19%遅くなったのに「20%速くなった」と体感していました。体感と実測の乖離という研究の系譜を追い、体感ROIだけで意思決定する危うさと実測の設計方法に着地させます。分析岡崎 太公開日2026年8月17日出典数出典 3件
論文レポート生成AI「生成AI導入の95%はP&L効果なし」をどう読むか — MIT NANDAレポートの定義・調査の限界・残り5%の構造「生成AI導入の95%は測定可能なP&L効果を生んでいない」——2025年夏に世界中で引用されたMIT Project NANDAのレポートを、原典に当たって検証します。95%が何の95%なのか、調査の母集団と「成功」の定義、レポート自身が明記する調査の限界を整理し、センセーショナルな数字に出会ったときの判断軸と「残り5%は何が違うのか」の構造分析に着地します。分析岡崎 太公開日2026年8月13日出典数出典 2件