Gemini 4 Hydrogen登場:上位のArgonに並んだのか? 8モデルでコーディング・文章作成を比較
- 公開
- 読了時間
- 29分で読めます
GoogleがGemini 4 Hydrogenを発表しました。日常のコーディングとエージェント作業に向けた高速なモデルで、評価機関の総合指標では上位のGemini 4 Argonを上回ったとしています。HydrogenとGemini 4 Carbon・Gemini 4 Argon・Gemini 3.8 Flash・Claude Sonnet 5.5・GPT-6.1 Sol・Claude Fable 5.2・Claude Opus 5.5の8モデルを、同じ評価環境のコーディングと文章・資料作成の公開評価、API単価と評価機関が算出した1タスクあたりの費用で比較します。
POINT
Gemini 4 Hydrogenのhigh設定は、上位のGemini 4 Argonとほぼ同じ総合指標を、Argonの約2.7分の1の費用で出し、評価機関が計算した1タスクの所要時間は8モデルで最も短いモデルです。Googleの環境で日常の開発作業を速く回すなら有力な候補です。ただし、評価と費用だけで比べると、GPT-6.1 Solがhigh設定のHydrogenを4つの評価すべてで上回り、費用も低く済みます。ターミナル上の作業ならGemini 4 CarbonかClaude Sonnet 5.5、提案書や報告書の作成ならClaudeの3モデルが適しています。
2026年11月13日時点の公式発表と評価機関の公開データに基づく比較です。当社で各モデルに同じ課題を解かせた実測は行っていません。用途の提案は、公開評価を踏まえた筆者の整理です。
比較の要点
| 評価・観点 | Gemini 4 Hydrogen(xhigh / high) | 8モデルの首位 |
|---|---|---|
| Intelligence Index v5.0.1(総合指標)Gemini 4 Hydrogen(xhigh / high):53.9 / 50.8。highはArgon(50.4)とほぼ同じ | 53.9 / 50.8。highはArgon(50.4)とほぼ同じ | Fable 5.2 |
| FrontierCode 2.0(オープンソースの開発課題)Gemini 4 Hydrogen(xhigh / high):39.0% / 36.3%。Argonを10ポイント以上上回る | 39.0% / 36.3%。Argonを10ポイント以上上回る | Fable 5.2 |
| Terminal-Bench 4.0(ターミナル作業)Gemini 4 Hydrogen(xhigh / high):53.5% / 54.0%。highはArgonより3.0ポイント低い | 53.5% / 54.0%。highはArgonより3.0ポイント低い | Gemini 4 Carbon |
| AA-Briefcase v1.1(業務成果物)Gemini 4 Hydrogen(xhigh / high):1,567 / 1,497。xhighはGPT-6.1 Solと同水準 | 1,567 / 1,497。xhighはGPT-6.1 Solと同水準 | Sonnet 5.5(Opus 5.5 とほぼ同等) |
| 1タスクあたりの費用Gemini 4 Hydrogen(xhigh / high):$3.16 / $1.87。highはArgonの約2.7分の1 | $3.16 / $1.87。highはArgonの約2.7分の1 | GPT-6.1 Sol(最も低い) |
2026年11月12日、GoogleはGemini 4 Hydrogenを発表しました。日常のコーディングとエージェント作業に向けた、速さと効率を重視したモデルです。価格は100万トークンあたり入力1.50ドル・出力7.50ドルです。
Googleは、評価機関Artificial Analysisの総合指標で、Hydrogenが上位モデルのGemini 4 Argonを上回ったと説明しています。速さと費用を重視したモデルが、上位のモデルに並んだのでしょうか。
今回は、Hydrogenを7つのモデルと比べます。Googleの上位モデルのGemini 4 CarbonとGemini 4 Argon、Googleが移行元として挙げるGemini 3.8 Flash、総合指標でHydrogenのすぐ上にいるClaude Sonnet 5.5とGPT-6.1 Sol、そして上位の基準としてClaude Fable 5.2とClaude Opus 5.5です。観点はこれまでの比較記事と同じく、コーディングと文章・資料作成の2つです。あわせて、Hydrogenの思考設定ごとの違いと、API単価と、評価機関が算出した1タスクあたりの費用を整理します。
出典:Googleの発表(2026年11月13日確認)
Gemini 4 Hydrogenで何が変わったのか
Googleの発表から、モデルを選ぶうえで押さえておきたい点を整理します。
- 役割:日常のコーディングとエージェント作業を速くこなすためのモデルです。長く深く考える仕事は、上位のCarbonとArgonが受け持ちます。Googleは、Gemini 3.8 Flashからの移行先としてHydrogenを案内しています。3.8 Flashの提供終了は発表されていません。
- 価格:100万トークンあたり入力1.50ドル・出力7.50ドルです。入力が長くなっても単価は変わりません。
- コンテキスト:入力・思考・出力を合わせて約105万トークン(1,048,576トークン)です。1回の応答で出力できるのは、既定で6万5,536トークンまでです。
- 思考設定:low・medium・high(既定)に、新しくxhighが加わりました。
- 速度:high設定で、3.8 Flashより約2.5倍速く作業を終えるとしています。ただし、どの作業で測った値かは示されていません。
- 上位モデルとの組み合わせ:開発環境のGoogle Antigravityでは、1つのセッションの中でCarbonとHydrogenを切り替える「Orchestrator」が使えます。計画をCarbonが立て、編集やテストの実行をHydrogenが受け持つ仕組みです。Googleの発表によると、Terminal-Bench 4.0ではCarbonに近い成功率のまま、利用枠の消費が約24%少なく、平均で約19%速く終わりました。なお、同じ数値をAntigravityのブログはTerminal-Bench 4.1と書いています。
Hydrogenは発表当日から、Gemini API(無料枠と有料枠)、Google AI Studio、Android Studio、Google Antigravity(有料のGoogle AI ProとUltra)、Geminiアプリ、Google検索で使えます。Geminiアプリの無料ユーザーには、問い合わせに合うとGeminiが判断したときに自動で使われます。モデルIDは gemini-4-hydrogen です。
出典:Googleの発表、Antigravityのブログ、Gemini APIのモデル一覧(2026年11月13日確認)
Googleが公表した評価値
Googleは発表で、HydrogenをClaude Sonnet 5.5とGPT-6.1 Terraの2モデルと比べた表を示しています。モデル選びに関わる項目を抜き出します。
| 評価(Google公表) | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep(開発作業) | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1(ターミナル作業) | 57.0% | 63.9% | - |
| Agents’ Last Exam v1.1(エージェント作業) | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA(業務自動化) | 76.1% | 71.8% | 60.2% |
| OSWorld-2.1(PCの操作) | 77.6% | 83.9% | 74.2% |
| Terminal-Bench-Science 0.1(科学分野のターミナル作業) | 51.4% | 59.9% | 58.3% |
| HLE-Diamond(難問の知識・推論) | 58.8% | 53.3% | 47.3% |
出典:Googleの発表の比較表(2026年11月13日取得)。表は画像で公開されており、値は画像から読み取りました。Hydrogenの値は、Terminal-Bench 4.1だけがhigh設定、ほかはxhigh設定です。比較相手の値は、主に各社の公表値や公開のリーダーボードの値です。
Googleの表自体も、Hydrogenがすべての項目で先頭ではないことを示しています。ターミナル作業、PCの操作、科学分野のターミナル作業の3項目では、Claude Sonnet 5.5が上です。
このほかGoogleは、Artificial Analysisの総合指標でHydrogenがhigh設定で51、xhigh設定で54、Gemini 4 Argonが50だったと説明しています。Terminal-Bench 4.1は、3.8 Flashの18.2%に対して57.0%でした。
Googleが示したTerminal-Bench 4.1は、本記事で使うArtificial AnalysisのTerminal-Bench 4.0とは版が違います。値はそのまま比べられません。また、Googleの表の比較相手のGPT-6.1 Terraは、本記事の8モデルには入れていません。
比較の前提:同じ評価環境で測った数値を軸にする
各社の発表資料は、比べる相手、思考設定、実行環境がそれぞれ異なります。そこで本記事でも、独立評価機関Artificial Analysis(以下AA)が同じ環境で測った数値を比較の軸にします。総合指標は、前回のFable 5.2比較記事と同じIntelligence Index v5.0.1です。8モデルすべての値を、2026年11月13日に取り直しました。
使う評価は次のとおりです。
| 観点 | 使う評価 | 単位 |
|---|---|---|
| コーディング | Terminal-Bench 4.0 / FrontierCode 2.0 | 正答率・スコア(%) |
| 文章・資料作成 | AA-Briefcase v1.1 | Eloレーティング |
| 費用 | 総合指標を解いたときの1タスクあたりの費用 | 米ドル |
設定は、AAが各モデルで評価した最上位の思考設定です。Claudeの3モデルとGPT-6.1 Solはmax、Gemini 4 Carbon・Gemini 4 Argon・Gemini 3.8 Flashはhighです。Hydrogenは、最上位のxhighに加えて、既定のhighも並べます。AAは、Claudeの3モデルの結果を「Max, Default Fallback」という設定名で掲載しています。安全対策が反応した要求を別のClaudeモデルへ回す、Anthropic既定のフォールバックを有効にして測った結果です。思考設定の名前が同じでも、モデルが違えば計算量や費用は同じではありません。
以下の割合と指数は小数第1位、Eloは整数に丸めています。AAのページでは、指数は整数(Hydrogenのxhighは54)で表示されます。差や倍率は、丸める前の値から計算しました。
本記事で信頼区間を確認したのはAA-Briefcaseだけです。ほかの評価の差は掲載値の大小を示すもので、統計的な有意性まで確認したものではありません。
まず、総合指標の値です。これは9つの評価をまとめた指数で、正答率ではありません。
| モデル(設定) | Intelligence Index v5.0.1 |
|---|---|
| Claude Fable 5.2(max) | 64.6 |
| Gemini 4 Carbon(high) | 60.0 |
| Claude Opus 5.5(max) | 59.1 |
| GPT-6.1 Sol(max) | 54.6 |
| Claude Sonnet 5.5(max) | 54.5 |
| Gemini 4 Hydrogen(xhigh) | 53.9 |
| Gemini 4 Hydrogen(high) | 50.8 |
| Gemini 4 Argon(high) | 50.4 |
| Gemini 3.8 Flash(high) | 30.8 |
出典:AAのIntelligence Indexと、AAの各モデルのページ(Hydrogen xhigh、Hydrogen high、Carbon、Argon、3.8 Flash、Sonnet 5.5、GPT-6.1 Sol、Fable 5.2、Opus 5.5)。2026年11月13日取得。以下の表で「各モデルのページ」と書いた出典は、この9ページを指します。
high設定のHydrogenは50.8で、Argonの50.4を0.4ポイント上回りました。Googleの「51対50」という説明どおりですが、差は小さく、「Argonと並んだ」と読むのが妥当です。3.8 Flashからは19.9ポイント上がっています。
xhigh設定では53.9まで上がり、GPT-6.1 Sol(54.6)とClaude Sonnet 5.5(54.5)のすぐ下に来ます。差はどちらも1ポイント未満です。Googleの最上位のCarbonとは6.1ポイント、8モデルの首位のFable 5.2とは10.6ポイントの差があります。
Gemini 4 Carbonは一般提供が始まった
Gemini 4 Carbonは、Googleが10月28日に発表した最上位のモデルです。前回の比較記事で確認した時点(11月10日)では、提供先が一部のサイバー防御者に限られていました。その後、Googleは11月10日(米国時間)に一般提供を始めました。
提供先は、Gemini APIを有料で使う開発者と企業、Google AI Ultraの契約者(Geminiアプリ、Antigravity、検索のAIモード)などです。Gemini APIの無料枠では使えません。単価は、2026年11月30日までの導入価格で入力2ドル・出力10ドル、12月1日からは入力4ドル・出力20ドルです。Argonも同じ単価と期限です。
出典:Googleの一般提供の告知、Gemini APIの価格表(2026年11月13日確認)
コーディング力:首位は評価で分かれ、HydrogenはFrontierCode 2.0でArgonを大きく上回る
コーディングは2つの評価で見ます。
- Terminal-Bench 4.0:ソフトウェア開発、機械学習、運用などの66件の作業を、ターミナル上で最後までやり遂げられるかを測ります。用意されたテストにすべて通った場合だけ成功と数え、各作業3回の平均を出します。
- FrontierCode 2.0:実在するオープンソースのリポジトリへの変更が、メンテナがマージできる水準かを測ります。132件の課題を各3回解かせ、非公開のテストと採点基準で点数を付けます。値は平均スコアで、合格率ではありません。
| モデル(設定) | Terminal-Bench 4.0 | FrontierCode 2.0 |
|---|---|---|
| Gemini 4 Hydrogen(xhigh) | 53.5% | 39.0% |
| Gemini 4 Hydrogen(high) | 54.0% | 36.3% |
| Gemini 4 Carbon(high) | 65.2% | 40.6% |
| Gemini 4 Argon(high) | 57.1% | 25.7% |
| Gemini 3.8 Flash(high) | 19.7% | 18.7% |
| Claude Sonnet 5.5(max) | 63.6% | 41.7% |
| GPT-6.1 Sol(max) | 56.1% | 40.6% |
| Claude Fable 5.2(max) | 59.6% | 48.8% |
| Claude Opus 5.5(max) | 59.6% | 46.4% |
出典:AAのTerminal-Bench 4.0とFrontierCode 2.0、各モデルのページ(2026年11月13日取得)。
Terminal-Bench 4.0:high設定でもArgonより3ポイント低い
首位はGemini 4 Carbonの65.2%で、Claude Sonnet 5.5の63.6%が続きます。
Hydrogenはhigh設定で54.0%でした。Argonより3.0ポイント、GPT-6.1 Solより2.0ポイント低い値です。xhighでは53.5%で、思考設定を上げてもこの評価の値は上がりませんでした。
一方、3.8 Flash(19.7%)からは34.3ポイント伸び、2.7倍になっています。Googleが示したTerminal-Bench 4.1(high設定)でも、3.8 Flashの18.2%に対して57.0%でした。版は違いますが、3.8 Flashから大きく伸びたという結果は共通しています。
FrontierCode 2.0:HydrogenはArgonを10ポイント以上上回る
こちらは、首位がClaude Fable 5.2の48.8%です。
Hydrogenはxhighで39.0%、highで36.3%でした。Argon(25.7%)をそれぞれ13.3ポイント、10.6ポイント上回ります。xhighは、GPT-6.1 SolとGemini 4 Carbon(どちらも40.6%)との差が2ポイント以内です。
2つの評価で、Argonとの上下が入れ替わる
HydrogenとArgonの上下は、2つの評価で逆になりました。オープンソースの開発課題(FrontierCode 2.0)ではHydrogenが大きく上回り、ターミナル作業(Terminal-Bench 4.0)ではArgonが上です。総合指標の「Argonを上回った」は、すべての評価で上回ったという意味ではありません。
導入時は、自分たちが実際に使う開発ツールで、代表的な不具合修正や機能追加を同じ開始地点から解かせて比べるのが確実です。
文章・資料作成:Claudeの3モデルが上位、Hydrogenは中位
文章・資料作成には、業務の成果物を評価するAA-Briefcase v1.1を使います。データ分析や事業戦略など4つのプロジェクト、計91件のタスクで、メモ・スライド・表計算などの成果物を作らせる評価です。要件の達成(合否)、分析の質、見せ方の3つを組み合わせて、総合のEloレーティングを出します。
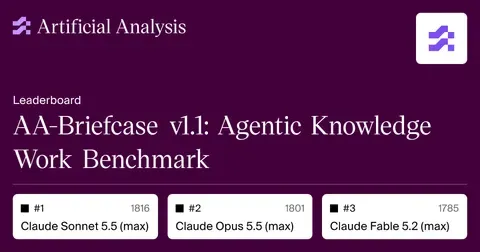
| モデル(設定) | 総合Elo | 95%信頼区間 |
|---|---|---|
| Claude Sonnet 5.5(max) | 1,816 | 1,806–1,828 |
| Claude Opus 5.5(max) | 1,801 | 1,790–1,811 |
| Claude Fable 5.2(max) | 1,785 | 1,773–1,798 |
| Gemini 4 Carbon(high) | 1,611 | 1,601–1,621 |
| Gemini 4 Hydrogen(xhigh) | 1,567 | 1,556–1,579 |
| GPT-6.1 Sol(max) | 1,555 | 1,546–1,563 |
| Gemini 4 Hydrogen(high) | 1,497 | 1,486–1,508 |
| Gemini 4 Argon(high) | 1,484 | 1,475–1,495 |
| Gemini 3.8 Flash(high) | 1,203 | 1,195–1,210 |
出典:AA-Briefcaseリーダーボードと各モデルのページ(2026年11月13日取得)。Eloは相対評価であり、正答率や満点に対する達成率ではありません。
上位はClaudeの3モデル、首位とHydrogenは約250点の差
首位はClaude Sonnet 5.5の1,816で、Opus 5.5(1,801)、Fable 5.2(1,785)が続きます。Sonnet 5.5とOpus 5.5の差は16点で、信頼区間が重なります。文章・資料作成では、Claudeの3モデルがほかの5モデルを大きく引き離しています。
Hydrogenはxhighで1,567でした。GPT-6.1 Sol(1,555)との差は12点で、信頼区間が重なる同じ水準です。首位のSonnet 5.5とは約250点の差があります。
high設定のHydrogen(1,497)とArgon(1,484)も、差は12点で信頼区間が重なります。この評価でも、highどうしのHydrogenとArgonは並んでいます。3.8 Flash(1,203)からは294点上がりました。
内訳:Hydrogenは見せ方が強く、分析の質と要件の合格率は低め
| モデル(設定) | 分析の質(Elo) | 見せ方(Elo) | 要件の合格率 |
|---|---|---|---|
| Claude Sonnet 5.5(max) | 2,100 | 1,726 | 65.2% |
| Claude Opus 5.5(max) | 2,126 | 1,724 | 61.2% |
| Claude Fable 5.2(max) | 2,014 | 1,705 | 66.1% |
| Gemini 4 Carbon(high) | 1,672 | 1,601 | 61.8% |
| Gemini 4 Hydrogen(xhigh) | 1,609 | 1,615 | 56.0% |
| GPT-6.1 Sol(max) | 1,761 | 1,460 | 55.7% |
| Gemini 4 Hydrogen(high) | 1,475 | 1,593 | 52.4% |
| Gemini 4 Argon(high) | 1,551 | 1,308 | 64.6% |
| Gemini 3.8 Flash(high) | 1,136 | 1,227 | 42.1% |
出典:AA-Briefcaseリーダーボードと各モデルのページ(2026年11月13日取得)。分析の質と見せ方は、それぞれ独立したEloです。
Hydrogenの特徴は見せ方です。xhighの1,615はClaudeの3モデルに次ぐ値で、Carbon(1,601)とは14点差の近い水準です。一方で、分析の質(1,609)はGPT-6.1 Sol(1,761)より低く、要件の合格率(56.0%)もArgon(64.6%)を下回ります。
Argonは逆の特徴を持っています。要件の合格率は64.6%と高い一方、見せ方は1,308と低めです。総合Eloが近いHydrogenとArgonでも、成果物の強みは違います。見せ方を重視するならHydrogen、要件の達成を重視するならArgonが合う、と読めます。
日本語の文章は、自分たちの原稿で比べる
AA-Briefcaseを含め、今回の評価は日本語の文章の自然さを測っていません。日本語で書かせる用途では、同じ資料・読者・文字数・文体指定を渡し、モデル名を伏せて読み比べる方法をおすすめします。比べる観点は、GPT-6 Astra比較記事の比較表にまとめています。
思考設定で変わるHydrogen:開発作業はhigh以上、mediumでも3.8 Flashを上回る
ここまでのHydrogenの値は、xhighとhighのものです。AAは、Hydrogenを4つの思考設定すべてで測っています。設定を変えると、評価と費用はどう変わるのでしょうか。
| 思考設定 | 総合指標 | Terminal-Bench 4.0 | FrontierCode 2.0 | AA-Briefcase | 1タスクの費用 |
|---|---|---|---|---|---|
| xhigh | 53.9 | 53.5% | 39.0% | 1,567 | $3.16 |
| high(既定) | 50.8 | 54.0% | 36.3% | 1,497 | $1.87 |
| medium | 41.2 | 29.3% | 31.5% | 1,296 | $0.80 |
| low | 26.9 | 6.6% | 9.3% | 947 | $0.29 |
| 比較:Gemini 3.8 Flash(high) | 30.8 | 19.7% | 18.7% | 1,203 | $7.77 |
| 比較:GPT-6.1 Sol(max) | 54.6 | 56.1% | 40.6% | 1,555 | $1.27 |
出典:AAのHydrogenの各設定のページ(xhigh、high、medium、low)と、3.8 Flash・GPT-6.1 Solのページ(2026年11月13日取得)。1タスクの費用は、総合指標を解いたときの値です。
読み取れることは4つあります。
- highからxhighへ上げると、費用は1.7倍になります。 総合指標は3.1ポイント、FrontierCode 2.0は2.6ポイント、AA-Briefcaseは70点上がりますが、Terminal-Bench 4.0は上がりません。xhighは、資料作成など品質を上げたい場面に向く設定と読めます。
- highからmediumへ下げると、費用は半分以下になりますが、ターミナル作業の評価が大きく下がります。 Terminal-Bench 4.0は54.0%から29.3%へ、24.7ポイント下がります。エージェントに開発作業を任せるなら、high以上を選ぶのが無難です。
- mediumでも、3.8 Flash(high)を4つの評価すべてで上回ります。 1タスクの費用は0.80ドルで、3.8 Flashの7.77ドルの約10分の1でした。3.8 Flashの用途を置き換えるなら、mediumから試す選択肢もあります。
- GPT-6.1 Sol(max)は、Hydrogenのxhighより1タスクの費用が低く、総合指標とコーディングの2評価も上です。 highのHydrogenに対しては、AA-Briefcaseを含む4つの評価すべてで上回り、費用も低く済みます。総合指標を解いたときの費用で比べる限り、費用対効果ではGPT-6.1 Solが先を行きます。
価格:単価も1タスクの費用(high設定)も、8モデルで2番目に低い
API単価
8モデルの100万トークンあたりの単価を並べます。
| モデル | 入力 | キャッシュ読み取り | 出力 |
|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $0.075 | $7.50 |
| Gemini 4 Carbon | $2.00(12月1日から$4.00) | $0.10($0.20) | $10.00($20.00) |
| Gemini 4 Argon | $2.00(12月1日から$4.00) | $0.10($0.20) | $10.00($20.00) |
| Gemini 3.8 Flash | $0.75(2027年1月1日から$1.50) | $0.075($0.15) | $3.75($7.50) |
| Claude Sonnet 5.5 | $2.00 | $0.10 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| Claude Fable 5.2 | $8.00 | $0.20 | $40.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
出典:Gemini APIの価格表、AnthropicとOpenAIの料金ページ(2026年11月13日取得)。括弧内は導入期間の後の単価です。
Hydrogenの単価は、3.8 Flashの導入価格を除けば8モデルで最も低い水準です。ただし、3.8 Flashは2027年1月1日から入力1.50ドル・出力7.50ドルになり、入力と出力はHydrogenと同じ単価になります。CarbonとArgonは12月1日に単価が2倍になり、入力と出力の単価はHydrogenの約2.7倍になります。
表に書ききれない条件もあります。
- Gemini APIの無料枠:HydrogenとGemini 3.8 Flashは無料枠でも使えます。CarbonとArgonは有料枠だけです。
- 長文料金:GPT-6.1 Solは、入力が27万2,000トークンを超えると、リクエスト全体で入力とキャッシュが2倍、出力が1.5倍になります。Geminiの4モデルとClaudeの3モデルには、入力が長いときの割増がありません。
出典:Gemini APIの価格表、OpenAIのGPT-6.1 Solのモデル仕様、Anthropicの料金ページ(2026年11月13日確認)
実際の費用は、モデルが使うトークン量で決まる
単価が低くても、同じ仕事にかかる費用が低いとは限りません。モデルが考えたり試したりする量が違うためです。AAは、総合指標を解いたときの1タスクあたりの費用を公表しています。
| モデル(設定) | 1タスクあたりの費用 | 1タスクあたりの出力トークン | 1タスクの所要時間 |
|---|---|---|---|
| Claude Fable 5.2(max) | $26.54 | 約27.4万 | 46.8分 |
| Claude Opus 5.5(max) | $10.04 | 約17.3万 | 25.2分 |
| Claude Sonnet 5.5(max) | $10.02 | 約28.5万 | 33.0分 |
| Gemini 3.8 Flash(high) | $7.77 | 約9.9万 | 14.8分 |
| Gemini 4 Carbon(high) | $5.48 | 約12.3万 | 27.4分 |
| Gemini 4 Argon(high) | $4.97 | 約11.6万 | 30.1分 |
| Gemini 4 Hydrogen(xhigh) | $3.16 | 約15.4万 | 13.5分 |
| Gemini 4 Hydrogen(high) | $1.87 | 約8.5万 | 8.3分 |
| GPT-6.1 Sol(max) | $1.27 | 約6.8万 | 22.0分 |
出典:AAの各モデルのページ(2026年11月13日取得)。キャッシュの利用を含む、Intelligence Index v5.0.1を解いたときの費用です。所要時間は、AAが出力トークンと出力速度から計算した値です。Carbon・Argon・3.8 Flashの費用は、導入価格で計算されています。
high設定のHydrogenは、1タスクあたり1.87ドルでした。Argonの2.7分の1、Carbonの2.9分の1で、8モデルではGPT-6.1 Sol(1.27ドル)に次いで低い値です。xhighでも3.16ドルで、Claude Sonnet 5.5(10.02ドル)の約3分の1です。ただし、GPT-6.1 Solと比べると、highで1.5倍、xhighで2.5倍かかります。
AAが計算した1タスクの所要時間は、high設定のHydrogenが8.3分で、8モデルで最も短い値でした。3.8 Flash(14.8分)の約1.8分の1です。Googleの「約2.5倍速い」よりは小さい差ですが、速く作業を終えるという方向は合っています。
3.8 Flashは、単価は最も低いのに、1タスクの費用は7.77ドルとHydrogen(high)の4.1倍でした。AAの費用の内訳では、7.77ドルのうち7.03ドルがキャッシュの書き込みに当たります。キャッシュの使い方によって、実際の費用は大きく変わると考えてください。
また、Carbon・Argon・3.8 Flashの費用は導入価格で計算された値です。導入期間の後は単価が2倍になるため、費用も上がります。目安として、前回の記事でAAが導入期間後の単価(入力4ドル・出力20ドル)で計算していたCarbonの1タスクの費用は、7.76ドルでした。
比較するなら、次の形で記録すると実態に近づきます。
完成までの総コスト = 全試行のAPI料金 + 人が確認・修正する時間の費用
前回の比較から何が変わったか
前回(11月10日)のFable 5.2比較記事からの主な変化は、次の3つです。
- Gemini 4 Carbonが使えるようになった:前回は一般提供の前でしたが、今回はGemini APIの有料枠で使えます。AAの掲載単価も導入価格(入力2ドル・出力10ドル)になり、Carbonの1タスクの費用は前回の7.76ドルから5.48ドルになりました。単価が違うため、前回の費用とはそのまま比べられません。
- Googleの速さ重視のモデルが、上位のArgonに並んだ:high設定のHydrogenは、総合指標がArgonとほぼ同じで、資料作成の評価も信頼区間が重なる同じ水準です。
- 文章・資料作成では、比較に加えたClaude Sonnet 5.5が首位:前回もリーダーボード全体の首位(1,813)として、6モデルの外で紹介したモデルです。今回は8モデルに入れたので、表の首位になりました(1,816)。Opus 5.5とは信頼区間が重なる差です。
まとめ:Hydrogenは「上位モデルに近い力を、速く使う」モデル
8モデルの公開評価から、仕事ごとの最初の候補は次のように整理できます。
- Googleの環境で、日常の開発作業を速く回す:Gemini 4 Hydrogen(high)。総合指標はArgonとほぼ同じで、AAが算出した1タスクの費用はArgonの約2.7分の1。出力トークンと出力速度から計算した所要時間も8モデルで最も短い
- 評価と費用を重視して作業を大量に回す:GPT-6.1 Sol。1タスクの費用が最も低く、high設定のHydrogenを4つの評価すべてで上回る
- ターミナル上の作業:Gemini 4 CarbonかClaude Sonnet 5.5
- 難しい実装や、範囲の大きい開発:Claude Fable 5.2。総合指標とFrontierCode 2.0で首位だが、1タスクの費用は8モデルで最も高い
- 提案書・報告書などの成果物:Claudeの3モデルが上位。Sonnet 5.5とOpus 5.5は信頼区間が重なる差
- Gemini 3.8 Flashの置き換え:Hydrogen。mediumでも3.8 Flashを4つの評価すべてで上回る
「Argonを上回った」というGoogleの説明は、総合指標では正しいものの、差は小さく、ターミナル作業では逆です。Hydrogenは、上位モデルを置き換えるというより、上位モデルに近い力を短い時間と、上位モデルより低い費用で使えるモデルだと読めます。GoogleがAntigravityでCarbonとHydrogenを切り替えて使う仕組みを用意しているのも、この役割分担を前提にしたものでしょう。
フィールフロウのAI仕様駆動開発の視点では、モデル選びの前に、任せる作業と完了条件を決めたいと考えています。
- コードなら、対象の不具合が解消し、既存機能を壊さず、レビューを通せること。
- 文書なら、出典に忠実で、読者が理解でき、指定した語調へ整っていること。
- どちらも、API料金と人の確認時間を含めて、完成までを比較すること。
公開評価で候補を絞り、自分たちの代表的な仕事で確かめる。Hydrogenは思考設定によって評価と費用が大きく変わるので、「どのモデルか」に加えて「どの設定か」も、同じ手順で確かめておくと判断しやすくなります。
関連記事
用語
- Artificial Analysis(AA)
- 本記事が性能比較の主軸に使った独立評価機関。同じ機関が同じ環境で測った掲載値をそろえて比べています。
- Intelligence Index v5.0.1
- AAの総合指標。9つの評価をまとめた指数で、正答率ではありません。
- 思考設定(thinking level)
- モデルがどれだけ考えるかを決める設定。Hydrogenはlow・medium・high・xhighの4段階で、既定はhighです。xhighはHydrogenで新しく加わりました。
- Max, Default Fallback
- AAがClaudeの3モデルの結果に付けている設定名。最上位の思考設定で、安全対策が反応した要求を別のClaudeモデルへ回すAnthropic既定のフォールバックを有効にして測った結果です。
- Terminal-Bench 4.0
- ターミナル上で複数の手順を進める作業の評価。66件の作業を各3回解かせ、用意されたテストをすべて通過して初めて成功になります。Googleが比較表で使ったTerminal-Bench 4.1とは版が違います。
- FrontierCode 2.0
- 実在するオープンソースのリポジトリへの変更が、メンテナがマージできる水準かを測る評価。132件の課題を各3回解かせた平均スコアで、合格率ではありません。
- AA-Briefcase v1.1
- メモ、スライド、表計算などの業務成果物を作る評価。4つのプロジェクト、計91件のタスクで、要件の達成、分析の質、見せ方を組み合わせて総合Eloを出します。
- Elo
- 相対評価の指標。正答率ではありません。
- 95%信頼区間
- 測定のぶれを見込んだ値の幅。2つのモデルの区間が重なる場合、どちらが上とは言い切れません。
- 1タスクあたりの費用
- AAが総合指標を解かせたときにかかったAPI費用を、1タスクあたりに直した値。キャッシュの利用を含みます。
- 導入価格
- 提供開始から一定期間だけ適用される割引の単価。Gemini 4 CarbonとArgonは2026年11月30日まで、Gemini 3.8 Flashは2026年12月31日までで、その後は単価が2倍になります。
よくある質問
Gemini 4 Hydrogenは、上位のGemini 4 Argonより優れていますか?
評価によって違います。Artificial Analysis(AA)の値をhigh設定どうしで比べると、総合指標は50.8対50.4でほぼ同じ、業務成果物のAA-Briefcaseは1,497対1,484で、信頼区間が重なる同じ水準です。オープンソースの開発課題を解くFrontierCode 2.0では36.3%対25.7%でHydrogenが10.6ポイント上回り、ターミナル作業のTerminal-Bench 4.0では54.0%対57.1%でArgonが3.0ポイント上です。総合指標を解いたときの1タスクの費用は、Hydrogenが1.87ドル、Argonが4.97ドルでした。
Gemini 3.8 Flashから切り替えるべきですか?
公開評価で見る限り、切り替えを検討する価値は大きいと言えます。high設定どうしでは、Hydrogenは総合指標で19.9ポイント、Terminal-Bench 4.0で34.3ポイント上回ります。AAが総合指標を解かせたときの1タスクの費用も、Hydrogenが1.87ドル、3.8 Flashが7.77ドルでした。ただし、100万トークンあたりの入力と出力の単価は、3.8 Flashの導入価格(2026年12月31日まで)がHydrogenの半分です。費用はキャッシュの使い方で大きく変わるため、自分たちの処理で確かめてください。なお、Googleは3.8 Flashの提供終了を発表していません。
Hydrogenは、どの思考設定から試すとよいですか?
開発作業なら、既定のhighがおすすめです。AAの値では、highからmediumへ下げると、Terminal-Bench 4.0が54.0%から29.3%へ大きく下がります。xhighはhighより1タスクの費用が1.7倍で、総合指標、FrontierCode 2.0、資料作成の評価は上がりますが、Terminal-Bench 4.0は上がりませんでした。資料作成の品質を上げたい場面でxhighを試すとよいでしょう。
HydrogenとGPT-6.1 Solは、どちらを選べばよいですか?
評価と費用で選ぶならGPT-6.1 Sol、速さで選ぶならHydrogenです。AAの値では、GPT-6.1 Sol(max)は総合指標、Terminal-Bench 4.0、FrontierCode 2.0で、Hydrogenのxhighとhighの両方を上回ります。資料作成のAA-Briefcaseは、xhighのHydrogen(1,567)とは信頼区間が重なる差で、highのHydrogen(1,497)よりは上です。1タスクの費用もGPT-6.1 Solが1.27ドルで最も低く、Hydrogenはhighで1.87ドル、xhighで3.16ドルです。一方、AAが計算した1タスクの所要時間は、Hydrogenがhighで8.3分、xhighで13.5分、GPT-6.1 Solが22.0分でした。Gemini APIの無料枠で試せる点と、入力が長くても単価が変わらない点もHydrogenの特徴です。
Gemini 4 Carbonは、いま使えますか?
使えます。Googleは2026年11月10日(米国時間)に一般提供を始めました。Gemini APIを有料で使う開発者と企業、Google AI Ultraの契約者などが対象で、Gemini APIの無料枠では使えません。単価は2026年11月30日までの導入価格で入力2ドル・出力10ドル、12月1日から入力4ドル・出力20ドルです。
日本語の文章を書かせるなら、どのモデルがよいですか?
今回の評価だけでは決められません。AA-Briefcaseは業務成果物の作成を測る評価で、日本語の文章の自然さは測っていません。同じ資料・読者・文字数・文体指定を渡し、モデル名を伏せて読み比べる方法をおすすめします。
この比較は、フィールフロウが自分で測った結果ですか?
いいえ。2026年11月13日時点のArtificial Analysisの掲載値と、各社の公式発表に基づく比較です。当社で各モデルに同じ課題を解かせた実測は行っていません。
参考資料
この記事は、次の一次情報に基づいています。数値や記述の詳細は各資料をご確認ください。
- Gemini 4 Hydrogen の公式発表Googleblog.google発行 確認
位置づけ、価格、思考設定、提供先、Google が公表した評価値(表は画像)、Antigravity の Orchestrator の説明(Terminal-Bench 4.0 と記載)
- Gemini 4 Hydrogen in Google AntigravityGoogleantigravity.google発行 確認
Orchestrator の仕組みと提供プラン。Orchestrator の評価を Terminal-Bench 4.1 と記載しており、Google の発表(4.0)と版の表記が違う
- Gemini 4 Carbon の一般提供の告知Googleblog.google発行 確認
Carbon の一般提供の開始と提供先(有料の API 利用者と企業、Google AI Ultra など)
- Artificial Analysis Intelligence IndexArtificial Analysisartificialanalysis.ai確認
総合指標 v5.0.1 の構成と各モデルの値
- Artificial Analysis の評価方法Artificial Analysisartificialanalysis.ai確認
各評価の課題数、試行回数、採点方法と、1 タスクあたりの費用の定義
- Gemini 4 Hydrogen(xhigh)のモデルページArtificial Analysisartificialanalysis.ai確認
xhigh 設定の各評価の掲載値、1 タスクの費用と所要時間
- Gemini 4 Hydrogen(high)のモデルページArtificial Analysisartificialanalysis.ai確認
high 設定の各評価の掲載値、1 タスクの費用と所要時間
- Gemini 4 Hydrogen(medium)のモデルページArtificial Analysisartificialanalysis.ai確認
medium 設定の各評価の掲載値と 1 タスクの費用
- Gemini 3.8 Flash のモデルページArtificial Analysisartificialanalysis.ai確認
high 設定の各評価の掲載値、掲載単価、1 タスクの費用とその内訳
この記事を引用する
岡崎 太「Gemini 4 Hydrogen登場:上位のArgonに並んだのか? 8モデルでコーディング・文章作成を比較」株式会社フィールフロウ、2026年11月13日、https://feelflow.net/blog/2026-11-gemini-4-hydrogen-model-comparison/
この記事を書いた人
岡崎 太
CTO / AIアーキテクト