
GPT-6 Astraが登場しました。前回のClaude Fable 5.1比較記事では、コーディングと文章・資料作成の公開評価を見ながら、モデルの使い分けを整理しました。
そこにAstraと、Googleの新しいGemini 3.8 Flashが加わると、選び方はどう変わるのでしょうか。
今回の結論は、難しい実装でAstraを試す理由が増えた一方、文章・資料作成ではClaudeも引き続き有力で、費用を抑えた反復作業にはGeminiを検討したい、というものです。最新モデルへすべてを切り替えるより、仕事を分けて選ぶ方が判断しやすくなっています。
本記事は2026年9月5日時点の公式発表と評価主体の公開データを整理した比較です。当社で5モデルに同じ課題を解かせた実測記事ではありません。数値から読み取れることと、実務で試すための仮説を分けて説明します。
まず結論:コーディングと文章執筆で候補を分ける
今回はAstra、前世代のGPT-5.6 Sol、前回の有力候補だったClaude Fable 5.1とOpus 5、追加のGemini 3.8 Flashを比較します。「Gemini 3.8」は以下、一般用途のFlashを指します。Googleが同時発表したセキュリティ向けのFlash Cyberとは区別します。
| やりたい仕事 | 最初に比較したい候補 | 判断のポイント |
|---|---|---|
| 複数ファイルの実装、調査、テストを繰り返す | GPT-6 Astra / Claude Fable 5.1 / Opus 5 | 指標によって優劣が変わる。修正完了率と人の手戻りを測る |
| 提案書・調査記事など、根拠と構成が重要な文章 | Claude Fable 5.1 / Opus 5 / GPT-6 Astra | 業務成果物の総合評価はClaudeが上位。Astraの改善も確認する |
| 大量の下書き、定型修正、複数案の比較 | Gemini 3.8 Flash | API単価の低さを生かせるか、品質と実消費量を測る |
| 既存の文書・スライド作成フローを続ける | GPT-5.6 Solも残して比較 | 新モデルでもすべての評価軸が改善するわけではない |
この表は、以下のデータを基にした試す順序の提案です。日本語の自然さや自社のコードとの相性まで、公開スコアで確定したものではありません。
コーディング力:Astraは複雑なターミナル作業で前進
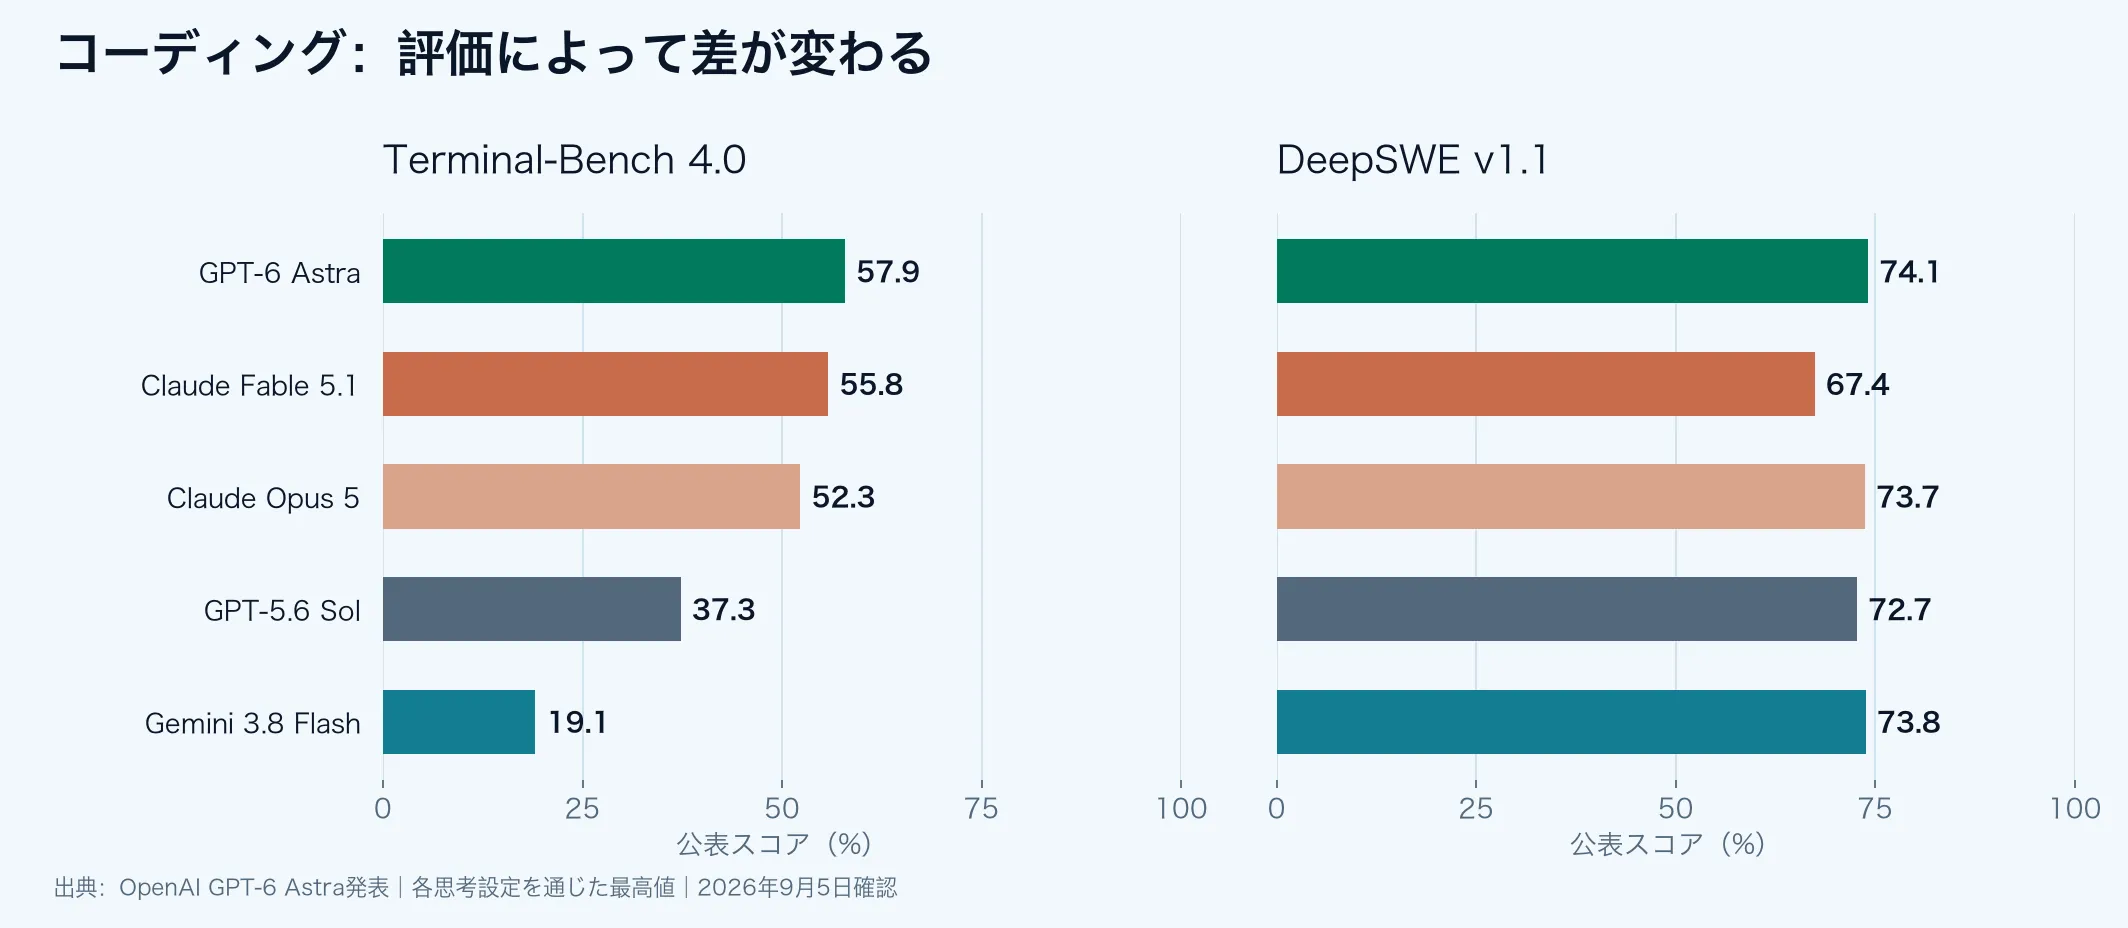
最初に、OpenAIのAstra発表にあるCoding比較表から、Terminal-Bench 4.0、DeepSWE v1.1、FrontierCode 1.1 Mainの3指標を転記します。表の数値はすべてこの公式発表を出典とし、別の版の評価値は混ぜていません。
| モデル | Terminal-Bench 4.0 | DeepSWE v1.1 | FrontierCode 1.1 Main |
|---|---|---|---|
| GPT-6 Astra | 57.9% | 74.1% | 53.3% |
| Claude Fable 5.1 | 55.8% | 67.4% | 50.9% |
| Claude Opus 5 | 52.3% | 73.7% | 53.4% |
| GPT-5.6 Sol | 37.3% | 72.7% | 47.5% |
| Gemini 3.8 Flash | 19.1% | 73.8% | 43.6% |
Terminal-Benchはターミナルを使う複雑な作業、DeepSWEは長いソフトウェア開発、FrontierCode 1.1 Mainはコードの品質を含む開発評価です。各列は別の評価であり、平均して「総合コーディング正答率」を作ることはできません。
出典:OpenAIのGPT-6 Astra発表・Coding比較表。公表値は各モデルの思考設定を通じた最高スコアで、GPTの評価は研究環境またはAPIで実施されています。ツールや指示などが製品版と異なり、同じ予算・同じ開発環境での独立比較を意味しません。
Astraは有力候補になった。ただし全指標の単独首位ではない
Terminal-Bench 4.0では、AstraはSolから20.6ポイント伸びています。一方、DeepSWEではAstraとGeminiの差は0.3ポイント、FrontierCode 1.1 MainではOpus 5がAstraを0.1ポイント上回ります。小差の統計的な有意性はこの表だけでは分かりません。
ここから読み取れるのは、難しい開発タスクでAstraを比較対象へ加える価値が高まったことです。「どんなコードでもAstraが一番」とまでは言えません。
独立評価も見ておきます。Artificial Analysisの9月3日評価では、Coding Agent IndexはAstraを使うCodexが67、Fable 5.1を使うClaude Codeが70でした。これは指数スコアで、正答率ではありません。また、モデルに加えてエージェントの実行環境も含む比較です。
Gemini 3.8 Flashは「Flashだから軽い仕事だけ」と決めつけない
DeepSWEではGeminiも上位に近い値を示します。Googleの開発者向け説明も、長時間の開発や複数ファイルの修正を主な改善領域に挙げています。一方、上表のTerminal-Benchでは差が大きく、難しい実装全般を同じように任せられるとは限りません。
実務では、代表的な不具合修正を同じ開始コミットから解かせ、テストが通るかだけでなく、不要な変更やレビューで直す箇所まで確認したいところです。途中でうまくいかない場合に、どこまで調べてから別モデルへ引き継ぐかも決めておくと、費用を比較しやすくなります。
文章執筆力:業務成果物の評価ではClaudeが引き続き強い
文章執筆には、事実を整理する力、構成する力、自然な言葉へ直す力があります。さらに、図表やスライドを含む資料として仕上げる力も関わります。これらを一つの点数にまとめると、用途とのずれが生まれます。
今回は前回と同じAA-Briefcaseを、文章・資料作成に近い公開指標として使います。複数週にわたる4つの業務プロジェクト、計91タスクを通じて成果物を評価し、要件への適合、分析品質、見せ方を統合したEloレーティングです。日本語の記事だけを評価した試験ではありません。
| モデルと評価設定 | AA-Briefcase(Elo) | 表示された95%信頼区間 |
|---|---|---|
| Claude Fable 5.1(max、既定フォールバックあり) | 1,666 | 1,656–1,676 |
| Claude Opus 5(max) | 1,650 | 1,643–1,658 |
| GPT-6 Astra(max) | 1,565 | 1,555–1,576 |
| GPT-5.6 Sol(max) | 1,481 | 1,474–1,489 |
| Gemini 3.8 Flash(high) | 1,206 | 1,197–1,215 |
出典:AA-Briefcaseリーダーボードを2026年9月5日に取得。Eloは相対評価であり、正答率や満点に対する達成率ではありません。設定名のmaxとhighも、各社で同じ計算量を表すものではありません。Fable 5.1は必要時に別モデルへ切り替わる既定設定を含みます。
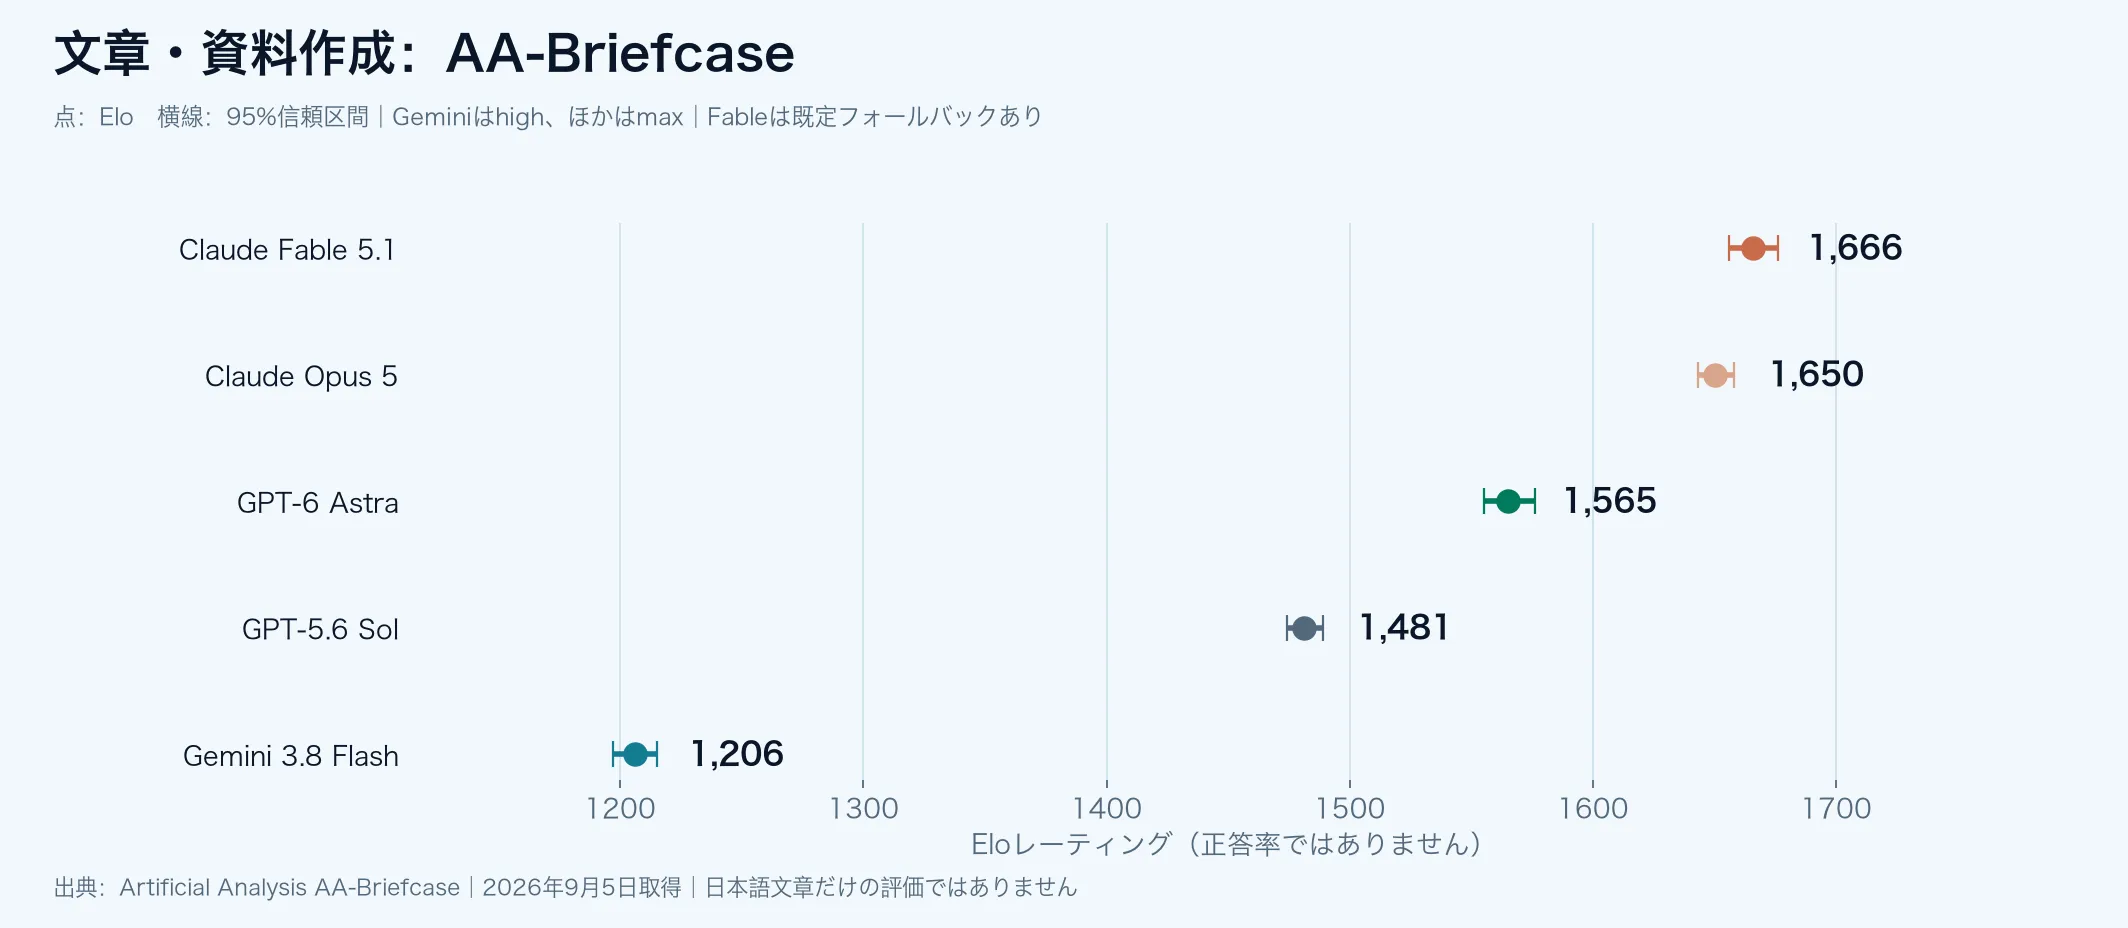
この比較では、AstraはSolを上回りますが、Fable 5.1とOpus 5には届きません。Fable 5.1とOpus 5の信頼区間は一部重なっているため、16点差だけで明確な優劣を断定しない方がよいでしょう。
なお、前回記事とは取得時点が異なります。Eloは評価対象や対戦結果の追加で再計算されるため、過去記事の値との増減を、そのままモデルの性能変化と読み替えないでください。
Astraの改善は、文章・資料作成の全工程で一様ではない
Artificial Analysisの内訳分析では、AstraはSolに対してAA-Briefcaseの要件適合と分析品質が改善した一方、見せ方の評価は低下しました。Solはこの分析時点で、見せ方の評価では全モデルの先頭でした。
提案書を例にすると、「主張と根拠を整理できるか」と「短く読みやすく、見やすい資料にできるか」は別の確認項目です。Astraの登場で、Solを使っていた文書フローを直ちに置き換える必要がある、という結論にはなりません。
日本語の自然さや創作文章は、別に確かめたい
AA-Briefcaseの順位から、「Claudeの日本語が必ず最も自然」「Geminiは文章を書けない」と結論づけることもできません。読みやすいブログ、顧客へのメール、小説では、必要な品質が異なるからです。
日本語の執筆用途なら、同じ資料を渡して次の観点で比較する方法を提案します。
| 観点 | 確認すること |
|---|---|
| 事実への忠実さ | 資料にない数字、体験談、顧客の発言を補っていないか |
| 構成 | 読者の疑問に答える順序になっているか。結論と根拠が対応するか |
| 自然な日本語 | 直訳調、抽象語の連続、不自然な強調が残っていないか |
| 語調と読者への適合 | 会社の文体、専門知識の前提、指定した温度感に合うか |
| 修正への対応 | 一部の修正依頼で、承認済みの内容を崩さないか |
たとえば「同じ資料から1,500字の解説記事を作る」「指定の一段落だけ柔らかく書き直す」の2段階で、モデル名を伏せて読み比べます。これは本記事で実施済みの試験ではなく、導入時の比較方法です。
API価格:AstraとFable 5.1は同単価、Geminiは低価格
下表は各社APIの通常処理における、100万テキストトークンあたりの米ドル価格です。キャッシュ、長文入力、優先処理などの追加条件を適用する前の基準単価を並べています。
| モデル | 入力 | 出力 | 主な補足 |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | キャッシュ読み取り $1 |
| Claude Fable 5.1 | $10 | $50 | キャッシュ読み取り $0.25 |
| Claude Opus 5 | $5 | $25 | Astra / Fable 5.1の半額 |
| GPT-5.6 Sol | $4 | $20 | 少なくとも2026年11月21日までの期間限定価格 |
| Gemini 3.8 Flash | $0.75 | $3.75 | 2026年12月31日までの導入価格 |
出典:AstraのAPI仕様、Fable 5.1の料金、Opus 5の発表、SolのAPI仕様、Gemini 3.8 Flashの開発者向け料金案内。
Geminiの導入価格はAstraの7.5%です。2027年1月1日からは入力$1.50、出力$7.50になると案内されています。AstraとSolは入力が27万2,000トークンを超えると、リクエスト全体で入力2倍・出力1.5倍の料金になります。Astraのキャッシュ料金もこの長文条件で2倍です。
ただし、単価の差がそのまま完成までの費用差になるわけではありません。Googleも、3.8 Flashは長い作業で検証を重ね、トークン使用量が増える場合があると説明しています。反対に、少ない試行で終われば、単価の高いモデルが安く済むことも考えられます。
比較するなら、次の形で記録すると実態に近づきます。
完成までの総コスト = 全試行のAPI料金 + 人が修正・確認する時間にかかる費用
ChatGPT、Claude、Googleのアプリ、GitHub Copilotには、それぞれプランや利用枠があります。このAPI表を各アプリの月額やクレジット消費へ直接当てはめることはできません。Astraの公式発表も段階的な提供を案内しているため、利用する製品での提供状況を確認してください。
過去の比較記事を読むときに注意したいこと
総合ランキングも更新されています。Artificial Analysisは9月4日にIntelligence Indexをv4.2へ更新し、評価の構成を変更しました。前回記事のv4.1系の点数と、現在のモデルページに表示されるv4.2の点数は、そのまま比べられません。
新モデルの記事では、数字が大きく動いたこと以上に、同じ評価の同じ版か、同じ設定か、いつ確認した値かが大切です。本記事では、コーディングの個別評価とAA-Briefcaseを分けて見せています。
Astra登場で変わるのは、仕事ごとの選択肢
前回からの変化は、難しい実装で試したいモデルにAstraが加わり、Gemini 3.8 Flashも費用を抑えながら比較する候補になったことです。一方、文章・資料作成の総合評価では、Claude Fable 5.1とOpus 5が引き続き強さを示しています。
FeelFlowのAI仕様駆動開発の視点では、モデル名だけでなく、任せる作業と完了条件を先に決めたいと考えます。
- コードなら、対象の不具合が解消し、既存機能を壊さず、レビューを通せること。
- 文章なら、出典に忠実で、読者が理解でき、指定した語調へ整っていること。
- どちらも、修正回数と人の確認時間を含めて、完成までを比較すること。
Astra、Claude、Geminiのどれか一つに決める前に、自分たちの代表タスクで使い分けを確かめる。その出発点として、今回の比較を役立てていただければと思います。