Gemini 4 Neon登場、Carbonの代わりになる? コードと文章で7モデルを比較
- 公開
- 読了時間
- 20分で読めます
GoogleがGemini 4 Neonを発表しました。NeonをGemini 4 Carbon・Gemini 4 Hydrogen、GPT-6.2 Astra・Sol、Claude Fable 5.2・Opus 5.5と比べ、既存コードの改修、ターミナル作業、業務資料の評価と1タスクあたりの費用を整理します。日本語の短文は7モデルに同じ依頼を出し、字数の守り方と数字の出所の書き方を確かめました。
POINT
比べた7モデルの中で、Gemini 4 Neon は業務資料の評価でClaudeの2モデルに次ぐ3位でした。既存コードの改修ではGemini 4 Carbonを3.8ポイント(既定のhighどうしでは2.7ポイント)上回りました。ターミナル作業はCarbonが首位で、1タスクあたりの費用が最も低いのは GPT-6.2 Sol です。
2026年11月19日確認。コーディング・業務資料・費用は評価機関Artificial Analysisの測定値で、各モデルでAAが測った最も高い思考設定(Neonはxhigh、Carbonはhigh)の値です。括弧内は既定のhighどうしの比較です。日本語の短文は7モデルの初回回答を各1本比較しました。
Gemini 4 Carbonで回している開発や資料作成を、新しいNeonに移せるでしょうか。11月18日(米国時間)、GoogleはGemini 4 Neonを発表しました。標準APIの単価は入力100万トークンあたり3ドル、出力15ドルです。Gemini APIのほか、Geminiアプリの有料プラン(Google AI Pro・Ultra)やGoogle Antigravityなどで提供が始まっています。Googleの発表
Googleの開発者ガイドでは、Neonを、日々大量にこなすエージェント作業に向くGemini 4 Hydrogenと、長く複雑な作業に向くGemini 4 Carbonの間に位置づけています。思考設定はlow・medium・high・xhighの4段階で、既定はhighです。Neonの開発者ガイド
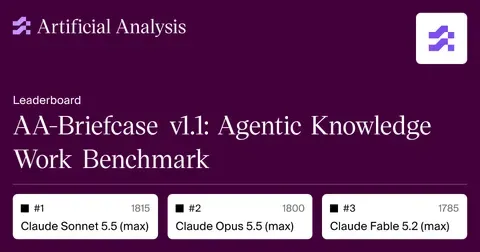
今回はGeminiの3モデルに加え、前回の比較で取り上げたGPT-6.2 AstraとSol、Claude Fable 5.2とOpus 5.5の計7モデルを比べます。前回、業務資料の評価で首位だったClaude Sonnet 5.5は今回の比較に入れていません(AAの業務資料の評価では1,815点で、今回の7モデルより上です)。普段の仕事に近い例として、Neonの発表を短くまとめた同じ資料を渡し、日本語の解説も書いてもらいました。
既存コードの改修では、NeonがCarbonを3.8ポイント上回る
「コーディング」には、既存のコードを読んで修正案を作る仕事も、ターミナルでコマンドを実行し、環境を動く状態にする仕事もあります。独立評価機関のArtificial Analysis(以下、AA)は、この2つを別々に測っています。
7モデルの思考設定と、コード改修・ターミナル作業の数値表開く表を開く閉じる
| モデル(思考設定) | 既存コードの改修(FrontierCode-AA 2.0) | ターミナル作業(Terminal-Bench 4.0) |
|---|---|---|
| Gemini 4 Neon(xhigh) | 44.4% | 63.6% |
| Gemini 4 Carbon(high) | 40.6% | 65.2% |
| Gemini 4 Hydrogen(xhigh) | 39.0% | 53.5% |
| GPT-6.2 Astra(max) | 45.4% | 64.1% |
| GPT-6.2 Sol(max) | 44.4% | 60.1% |
| Claude Fable 5.2(max) | 48.8% | 59.6% |
| Claude Opus 5.5(max) | 46.4% | 59.6% |
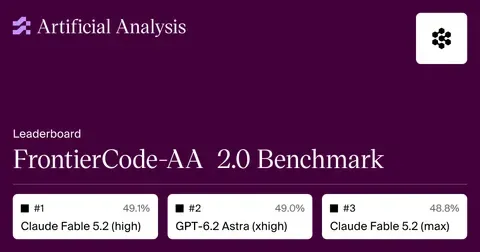
図と表には、各モデルでAAが測った最も高い思考設定の値を使いました。GPTとClaudeはmax、NeonとHydrogenはxhigh、Carbonはhighです。表の太字は各列の最高値です。思考設定を上げれば点が上がるとは限らず、FrontierCode-AA 2.0の順位表では、Fableのhigh(49.1%)とAstraのxhigh(49.0%)が上位に並びます。ClaudeはAAの「Max, Default Fallback」で、特定の理由で応答が拒否された場合に別のClaudeで再試行できる設定です。Anthropicの代替モデルの仕組み・FrontierCode-AA 2.0の結果と評価方法・Terminal-Bench 4.0の結果と評価方法
既存コードの改修では、NeonがCarbonを上回り、GPT-6.2 Solと並びました。 FrontierCode-AA 2.0では、実際のオープンソースのリポジトリを題材に、132の課題でモデルが作った変更がメンテナーの受け入れ条件をどこまで満たすかを採点します。NeonはCarbonを3.8ポイント、Hydrogenを5.4ポイント上回り、Solとは小数第1位まで同じ44.4%でした。首位のFableとは4.4ポイント差です。AAの実装評価
Googleは発表で、FrontierCode 2.0のスコアを46.2%(high)としています。AAが独自の実行環境で測ったhighの値は43.3%で、この記事のグラフはAAの値でそろえています。Googleの公表値・AAのNeonの評価
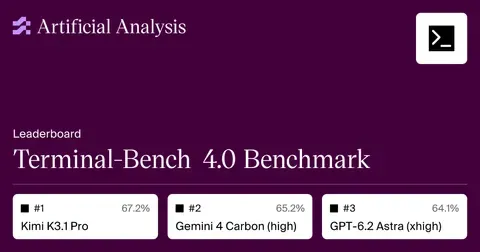
ターミナル作業では、7モデルの中でCarbonが首位を守りました。 Terminal-Bench 4.0は、ソフトウェアや運用などの66課題を対象に、各課題のテストをすべて通せた割合を測ります。NeonはCarbonに1.6ポイント、Astraに0.5ポイント届かず3位でしたが、Solを3.5ポイント、Claudeの2モデルを4.0ポイント上回りました。Hydrogenとは10.1ポイント差です。AAは66課題を各3回実行した平均を示しており、1課題の3回すべての成否が変わると約1.5ポイント動きます。上位3モデルの差は、その1課題分前後です。Googleの発表にある65.2%は版の異なるTerminal-Bench 4.1の値で、Carbonの4.0での値とたまたま同じ数字ですが、このグラフの63.6%とはそのまま比べられません。AAのターミナル評価
業務資料では、7モデル中NeonがClaudeの2モデルに次ぐ3位
「会議資料をまとめて、意思決定に使える報告書にして」と頼む場合、文章の滑らかさに加えて、必要な数値を拾えたか、結論を資料で裏づけられたかが重要です。AA-Briefcase v1.1は、メモ、表計算、プレゼン資料などを作る91課題を使い、要件への適合、分析の質、見せ方を合わせて評価します。Eloは成果物を比較して付ける相対的な点数です。AA-Briefcaseの採点方法
7モデルの総合Eloと95%信頼区間表開く表を開く閉じる
| モデル(思考設定) | 業務資料の総合Elo | 95%信頼区間 |
|---|---|---|
| Claude Opus 5.5(max) | 1,800 | 1,790〜1,811 |
| Claude Fable 5.2(max) | 1,785 | 1,773〜1,796 |
| Gemini 4 Neon(xhigh) | 1,700 | 1,690〜1,711 |
| GPT-6.2 Astra(max) | 1,643 | 1,632〜1,655 |
| GPT-6.2 Sol(max) | 1,612 | 1,603〜1,623 |
| Gemini 4 Carbon(high) | 1,611 | 1,601〜1,621 |
| Gemini 4 Hydrogen(xhigh) | 1,568 | 1,557〜1,579 |
総合Eloと信頼区間は、11月19日の順位表の値を整数に丸めました。新しいモデルが加わると全体のEloが計算し直されるため、前回の記事の値とは、総合Eloや信頼区間が1〜2点ずれるモデルがあります。
Neonは、GeminiとGPTの5モデルの中では最も高い1,700点でした。 Carbonを89点、Astraを57点上回り、信頼区間もどちらとも重なりません。一方でOpusとは100点、Fableとは85点の差があり、Claudeの2モデルには届いていません。報告書や提案書の下書きに限れば、Claudeを使っているチームがNeonへ乗り換える理由にはなりません。一方、Carbonを使っているチームには、Neonへ移す根拠になる結果です。AA-Briefcaseの順位表
思考設定で変わるNeon:既定のhighでも総合指標はCarbonとほぼ同じ
AAはNeonの4つの思考設定をすべて評価しています。既定のhighでも、総合指標はCarbon(high)を0.4ポイント下回るだけで、既存コードの改修は2.7ポイント、業務資料は21点上回りました。ただし業務資料は、Neon(high)の95%信頼区間が1,622〜1,642で、Carbon(high)の1,601〜1,621とほぼ接しており、差は小さいと見るのが妥当です。
| 思考設定 | 総合指標 | 既存コードの改修 | ターミナル作業 | 業務資料のElo | 1タスクあたりの費用 | 1タスクあたりの推論時間 |
|---|---|---|---|---|---|---|
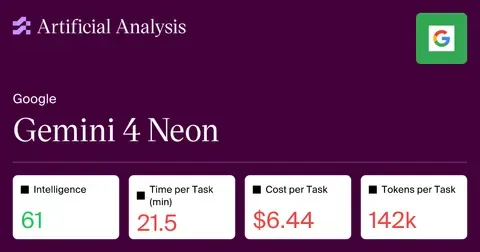
| xhigh | 61.4 | 44.4% | 63.6% | 1,700 | $6.44 | 21.5分 |
| high(既定) | 59.6 | 43.3% | 61.6% | 1,632 | $3.74 | 14.8分 |
| medium | 54.9 | 36.9% | 54.5% | 1,518 | $1.90 | 8.3分 |
| low | 44.1 | 26.9% | 32.8% | 1,297 | $0.75 | 3.7分 |
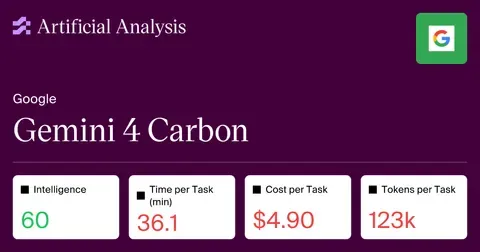
| 参考:Carbon(high) | 60.0 | 40.6% | 65.2% | 1,611 | $4.90 | 36.1分 |
総合指標はAAのIntelligence Index v5.0.1で、業務資料を含む9つの評価をまとめた値です。費用と推論時間は、AAがその評価で測った1タスクあたりの値です。xhighにすると、highより総合指標が1.8ポイント、業務資料が68点上がる一方、費用は約1.7倍になります。ターミナル作業の合格率はhighとxhighで2.0ポイント差、mediumではさらに7.1ポイント下がるため、コマンドを試しながら進める作業ではhigh以上が目安です。AAのNeonの評価・AA-Briefcaseの順位表
AAの総合指標61.4(xhigh)は、今回の7モデルではFable(64.6)とAstra(62.1)に次ぐ3番目です。Googleも発表で、NeonがAAの総合指標で3位だと説明しています。
日本語で同じ解説を書くと、どこに差が出るか
業務資料の点数からは、「日本語で180字に収めて」「資料にないことを補わないで」といった編集上の頼みにどう応えるかまでは分かりません。そこで、Neonの発表を短くまとめた共通の資料で試しました。GPTの2モデルにはCodex、Claudeの2モデルにはClaude Code、Geminiの3モデルにはGoogle Antigravityのコマンドライン版(agy)で依頼し、思考設定はすべてmediumを指定しました。各ツールの個人用の指示ファイル(AGENTS.md・CLAUDE.mdなど)を読み込まない新しい会話で、最初に返った原稿を掲載しています(11月19日実行)。
7モデルに渡した依頼と資料の全文原文 ・ 依頼文と発表資料開く全文を開く閉じる
次の発表資料だけを使い、AIを業務で使い始めた人向けに、2つのモデルの選び方を日本語で説明してください。見出し1行と本文120〜180字で、本文は1段落。両モデルの名前、評価の条件、数値、読み手が次にできることを含めてください。資料にない性能や日本語の優劣を補わず、外部検索やツールを使わずに答えてください。
発表資料:Googleは2026年11月18日、Gemini 4 Neonを発表した。同社はNeonを、複雑なソフトウェア開発や知識労働、科学の作業を速く最後まで終えるモデル、Gemini 4 Carbonを同社で最も高性能な推論モデルと位置づけている。同社によると、Neonは標準の思考設定highで、独立評価機関の総合指標で測った1タスクあたりの費用がCarbonより32%低い。API料金は出力100万トークンあたり、Neonが15ドル、Carbonが12月1日から20ドル。この発表には日本語の文章の評価は含まれていない。
180字の上限に収まったのは7モデル中6モデル
破線は本文の上限180字です。指定は120〜180字。全モデルが下限を満たしており、棒が破線を越えた分だけ短くする必要があります。
- Gemini 4 Neon176字
- Gemini 4 Carbon169字
- Gemini 4 Hydrogen177字
- GPT-6.2 Astra183字
- GPT-6.2 Sol178字
- Claude Fable 5.2177字
- Claude Opus 5.5178字
| モデル | 本文の字数(指定は120〜180字) | 編集者として気になった点 |
|---|---|---|
| Gemini 4 Neon | 176字 | 用途、条件、費用、単価までそろう。「同社によると」が抜け、32%が何と比べた値かも書かれていない。「最も高性能な推論」は「同社で」の限定が抜けた |
| Gemini 4 Carbon | 169字 | 用途の説明は資料に忠実で、「Googleで」と範囲も残した。32%をGoogleの説明として示しておらず、単価は省いた |
| Gemini 4 Hydrogen | 177字 | 単価まで収めた。「知識労働等」は硬く、「最高性能の推論」は「同社で」の限定が抜けた。結びはNeonだけを勧める |
| GPT-6.2 Astra | 183字 | 「同社は報告しています」で出所を示し、業務を1件選んで両方の出力を比べる提案が具体的。単価は省いた。3字超過 |
| GPT-6.2 Sol | 178字 | 出所と数字は正確。体言止めと常体の文に敬体の結びが混じり、「順に15ドル、12月1日から20ドル」は読み返さないと対応が分かりにくい |
| Claude Fable 5.2 | 177字 | 出所、条件、単価を収めた。Neonの位置づけは「費用なら」に置き換わり、速さは抜けた。本文の後に「(本文177字)」と字数を自己申告しており、掲載時に1行消す必要がある |
| Claude Opus 5.5 | 178字 | 出所を示し、自社の日本語業務で結果と費用を比べる提案まで書いた。2モデルの位置づけ(速さと最上位の推論)は抜けた |
字数は見出しと前後の空白を除き、本文中の空白・英数字・句読点を各1字として数えました。Fableの自己申告の177字は、この数え方と一致しています。
7本とも、思考設定のhighと32%という数字は残しました。差が出たのは、その32%を誰の説明として書いたかです。依頼文で出所の明記までは求めていませんが、資料は「同社によると」と断っています。Geminiの3モデルはこの断りを省き、評価機関の結果として言い切りました。GPTとClaudeの4モデルは、Googleの説明であることを残しています。各モデル1本ずつの比較なので傾向とまでは言えませんが、発表資料を要約させるときは、数字の出所がどう書かれたかを確かめておくと安心です。
今回の1本に限れば、筆者がほぼそのまま使えると判断したのはFableの原稿です。末尾の字数メモを消せば、出所、条件、単価、読み手の次の行動が177字に収まっています。Neonの「速さ」が抜けた点は、掲載前に補いたいところです。読み手の行動を最も具体的に書いたのはAstraで、「普段の業務を1件選び、両方の出力を比べてみましょう」と結んでいます。Astraの原稿(183字)は、3字削れば180字の上限に収まります。
7モデルの見出しと本文読み比べ開く開く閉じる
Gemini 4 Neon
Gemini 4 NeonとGemini 4 Carbonの選び方
複雑な作業を速く終えるならGemini 4 Neon、最も高性能な推論ならGemini 4 Carbonを選びます。標準の思考設定high、独立評価機関の総合指標ではNeonの1タスクあたりの費用が32%低く、API料金は出力100万トークンあたり15ドル(Carbonは12月1日から20ドル)です。日本語の評価は発表にないため、実務で試しましょう。
Gemini 4 Carbon
業務の目的と費用で選ぶGemini 4の2モデル
複雑な開発や知識労働、科学の作業を速く終えるならGemini 4 Neon、Googleで最も高性能な推論ならGemini 4 Carbonを選びます。標準の思考設定highで独立評価機関の総合指標で測った1タスクの費用はNeonがCarbonより32%低いです。日本語の文章評価は含まれないため、まずは実際の業務で試して確認しましょう。
Gemini 4 Hydrogen
業務でのGemini 4 NeonとCarbonの選び方
知識労働等を速く終えるならGemini 4 Neon、最高性能の推論ならGemini 4 Carbonを選びます。標準の思考設定highで測った独立評価機関の総合指標ではNeonの1タスク費用がCarbonより32%低く、出力100万トークンは15ドル(Carbonは12月1日から20ドル)です。日本語評価はないため、まずNeonで実務を試しましょう。
GPT-6.2 Astra
Gemini 4 NeonとGemini 4 Carbonの選び方
Googleは、複雑な業務を速く終える用途にNeonを、推論を最優先する用途に同社最高性能の推論モデルCarbonを位置づけています。Neonは標準の思考設定highで、独立評価機関の総合指標における1タスクあたりの費用がCarbonより32%低いと同社は報告しています。日本語の文章は今回の評価に含まれないため、普段の業務を1件選び、両方の出力を比べてみましょう。
GPT-6.2 Sol
業務で使うGemini 4の選び方
複雑な作業を速く終えたいならGemini 4 Neon、推論重視ならGemini 4 Carbon。Googleによると、Neonは標準の思考設定highで、独立評価機関の総合指標では1タスクの費用がCarbonより32%低い。API出力100万トークンは順に15ドル、12月1日から20ドル。日本語の評価は資料にないため、普段の業務で両方を試しましょう。
Claude Fable 5.2
Gemini 4 NeonとCarbon、費用か推論性能かで選ぶ
費用ならGemini 4 Neon、推論性能ならGemini 4 Carbonが候補です。Googleによると、Neonは標準の思考設定highで、独立評価機関の総合指標で1タスクあたりの費用がCarbonより32%低く、出力100万トークンあたりNeonが15ドル、Carbonは12月1日から20ドルです。日本語の評価はないため、業務で試しましょう。
(本文177字)
Claude Opus 5.5
Gemini 4 NeonとCarbonは費用を比べてから、自社の業務で試して選ぶ
Googleによると、Gemini 4 Neonは標準の思考設定highで、独立評価機関の総合指標による1タスクあたりの費用がGemini 4 Carbonより32%低い。出力100万トークンあたりのAPI料金はNeonが15ドル、Carbonが12月1日から20ドル。日本語の評価は発表にないため、自社の日本語業務で両方を試し、結果と費用を比べるとよい。
見出しに付いていたMarkdownの記号(見出しや太字の記号)は外して掲載しました。本文は句読点や改行も含めて原文のままです。
料金は、評価の1タスクあたりいくらか
APIの入出力単価が同じでも、モデルが読み書きするトークン量やキャッシュの使い方で費用は変わります。次のグラフは1タスクあたりの費用、表の右側2列は費用と推論時間で、いずれもAAがIntelligence Index v5.0.1の9評価で測った値です。失敗した試行の分も含む評価全体の平均なので、自社の仕事1件を仕上げるまでの費用とは一致しません。上の日本語原稿1本の料金とは対象が異なります。
Neonの1タスクあたりの費用は、highで3.74ドル、xhighで6.44ドル
AAのIntelligence Index v5.0.1の9評価から算出した加重平均費用です。棒が短いほど1タスクあたりの費用が低くなります。
- GPT-6.2 Sol$1.01
- Gemini 4 Hydrogen$3.16
- Gemini 4 Neon(high)$3.74
- GPT-6.2 Astra$4.00
- Gemini 4 Carbon$4.90
- Gemini 4 Neon(xhigh)$6.44
- Claude Opus 5.5$10.04
- Claude Fable 5.2$26.54
| モデル(思考設定) | 標準入力/100万トークン | 標準出力/100万トークン | AAの1タスクあたりの費用 | AAの1タスクあたりの推論時間 |
|---|---|---|---|---|
| Gemini 4 Neon(xhigh) | $3 | $15 | $6.44 | 21.5分 |
| Gemini 4 Neon(high) | $3 | $15 | $3.74 | 14.8分 |
| Gemini 4 Carbon(high) | $2(12月から$4) | $10(12月から$20) | $4.90 | 36.1分 |
| Gemini 4 Hydrogen(xhigh) | $1.50 | $7.50 | $3.16 | 15.3分 |
| GPT-6.2 Astra(max) | $8 | $40 | $4.00 | 13.7分 |
| GPT-6.2 Sol(max) | $2 | $10 | $1.01 | 8.5分 |
| Claude Fable 5.2(max) | $8 | $40 | $26.54 | 41.2分 |
| Claude Opus 5.5(max) | $4 | $20 | $10.04 | 24.6分 |
表は米ドルで、入力はキャッシュを使わない場合の単価です。右側2列の太字は最も低い値です。Neonのキャッシュ済み入力は100万トークンあたり0.15ドルで、通常の入力より95%安くなります。Carbonの単価は11月30日までのもので、12月1日から入出力とも2倍になる予定です。Geminiの料金・Anthropicの標準料金・GPT-6.2 Astraの料金・GPT-6.2 Solの料金
Carbonとの費用の差は、11月中と12月以降で大きく変わります。 AAはCarbonの費用を、入出力は11月30日までの単価、キャッシュ読み込みは100万トークンあたり0.20ドル(Googleの料金表では12月1日以降の単価)で計算しています。AAが公開しているトークン量の内訳を使い、当社で単価だけを置き換えて計算し直すと、Carbon(high)の1タスクあたりの費用は、11月30日までの単価で約3.88ドル、12月1日以降の単価で約7.76ドルです。Neon(high)の3.74ドルと比べると、11月中はほぼ同じで、12月からは約半分になります。AAのCarbonの評価と費用
Carbon(high)の1タスクあたりの費用の内訳と試算表開く表を開く閉じる
| 費用の内訳(100万トークンあたりの単価) | AAの掲載値 | 11月30日までの単価で試算 | 12月1日以降の単価で試算 |
|---|---|---|---|
| キャッシュを使わない入力($2→$4) | $0.02 | $0.02 | $0.05 |
| キャッシュへの書き込み(入力と同じ $2→$4) | $1.61 | $1.61 | $3.21 |
| キャッシュ読み込み($0.10→$0.20) | $2.04 | $1.02 | $2.04 |
| 出力($10→$20) | $1.23 | $1.23 | $2.46 |
| 合計 | $4.90 | $3.88 | $7.76 |
AAが掲載した内訳のトークン量はそのままに、単価だけを置き換えて計算しました。AAの掲載値は、キャッシュ読み込みだけが12月1日以降の単価です。各行は小数第3位を四捨五入しています。
Googleは、既定のhighで比べたNeonの1タスクあたりの費用を「Carbonより32%低い」と説明しています。11月19日のAAの値どうし(3.74ドルと4.90ドル)では約24%です。前回の記事で確認した11月18日のCarbonの値(5.48ドル)を使うと約32%になり、Googleの数字に近づきますが、Neonの11月18日時点の値は確認できていません。AAの費用は日によって変わることがあるため、比べるときは両モデルの確認日をそろえてください。
推論時間も見ておきます。Neon(xhigh)の21.5分はCarbon(high)の36.1分より短い一方、AstraやSolよりは長くかかります。Googleの言う「速さ」は、同社の上位モデルであるCarbonと比べたものと読むのが妥当です。
AAのモデル別内訳:Neon・Carbon・Hydrogen・Astra・Sol・Fable・Opus
Geminiを使うなら、まずCarbonの仕事をNeonで試す
Gemini 4 Carbonで既存コードの改修や報告書づくりを回しているなら、最初に試したいのはNeonです。既定のhighでも、Neonはコード改修と業務資料の評価でCarbonを上回り、AAの1タスクあたりの推論時間は半分以下でした。1タスクあたりの費用は、11月中はCarbonとほぼ同じです。12月にCarbonの単価が2倍になると、入出力の単価はNeonがCarbonの4分の3になり、AAの評価で各モデルが使ったトークン量のまま計算すると、Neonの費用はCarbonの約半分になります。業務資料でCarbonとの差をはっきり出すならxhighですが、費用はhighの約1.7倍になります。ターミナルでの試行錯誤が多い仕事は、7モデル中で首位を守ったCarbonと並べて比べる価値があります。
7モデルの中では、Neonはターミナル作業と業務資料で3位、コード改修でSolと並ぶ4位で、どの評価でも4位以内に入りました。コード改修だけならFable、業務資料ならOpusとFable、費用ならSolに分があります。日本語の短文では、今回の1本に限ると、Geminiの3モデルとも字数は守った一方、資料にあった「同社によると」を省きました。直近で作った資料や修正を1つ選び、同じ依頼をNeonと今のモデルに出して、数字の出所まで比べてみてください。
参考資料
この記事は、次の一次情報に基づいています。数値や記述の詳細は各資料をご確認ください。
参考資料 12 件を表示参考資料を閉じる
- Claude APIの料金表Anthropicplatform.claude.com確認
この記事を引用する
岡崎 太「Gemini 4 Neon登場、Carbonの代わりになる? コードと文章で7モデルを比較」株式会社フィールフロウ、2026年11月19日、https://feelflow.net/blog/2026-11-gemini-4-neon-model-comparison/
この記事を書いた人
岡崎 太
CTO / AIアーキテクト