GPT-6.2 AstraとSol、コードと文章でどう選ぶ? 8モデルを比較
- 公開
- 最終確認
- 読了時間
- 15分で読めます
GPT-6.2 AstraとSolを前世代のGPT、Claude Fable 5.2、Claude Opus 5.5、Claude Sonnet 5.5、Gemini 4 Carbonと比較しました。既存コードの改修、ターミナル作業、業務資料で変わる評価と費用を整理し、日本語の短文は8モデルに同じ依頼を出して、条件の守り方と読みやすさを確かめます。
POINT
既存コードの改修なら、まず GPT-6.2 Sol を試したいところです。独立評価で旧Astraを上回り、新Astraとの差は1.0ポイントでした。ターミナル作業の合格率は新Astraが新Solより4.0ポイント高く、業務資料の総合Eloでは Claude Sonnet 5.5 が8モデルで首位でした。
2026年11月18日確認。日本語の短文は8モデルの初回回答を各1本比較しました。コーディングの数値は評価機関の測定結果です。
これまでGPT-6 Astraに任せていたコードの改修を、料金の安いSolに移せるでしょうか。11月17日、OpenAIは難しい仕事向けのGPT-6.2 Astraと、日常業務向けのGPT-6.2 Solを発表しました。標準APIの出力100万トークンはAstraが40ドル、Solが10ドルです。OpenAIの発表
今回は新旧のAstraとSolに加え、前回の比較で、実装に強かったClaude Fable 5.2、ターミナル作業に強かったGemini 4 Carbon、業務資料で首位だったClaude Sonnet 5.5を取り上げます。Claude Opus 5.5も加え、同じClaudeの3モデルで得意な仕事がどう違うかを見ていきます。さらに、普段の仕事に近い例として、同じ発表資料を渡して日本語の短い解説を書いてもらいました。
コードの改修では新Solが旧Astraを上回る
「コーディング」には、既存のコードを読んで修正案を作る仕事も、ターミナルでコマンドを実行し、環境を動く状態にする仕事もあります。独立評価機関のArtificial Analysis(以下、AA)は、この2つを別々に測っています。
8モデルの思考設定と、コード改修・ターミナル作業の数値表開く表を開く閉じる
| モデル(思考設定) | 既存コードの改修(FrontierCode-AA 2.0) | ターミナル作業(Terminal-Bench 4.0) |
|---|---|---|
| GPT-6.2 Astra(max) | 45.4% | 64.1% |
| GPT-6.2 Sol(max) | 44.4% | 60.1% |
| GPT-6 Astra(max) | 42.4% | 59.1% |
| GPT-6.1 Sol(max) | 40.6% | 56.1% |
| Claude Fable 5.2(max) | 48.8% | 59.6% |
| Claude Opus 5.5(max) | 46.4% | 59.6% |
| Claude Sonnet 5.5(max) | 41.7% | 63.6% |
| Gemini 4 Carbon(high) | 40.6% | 65.2% |
図と表はGPTとClaudeをmax、Geminiをhighで比較しています。表の太字は各列の最高値です。ClaudeはAAの「Max, Default Fallback」で、特定の理由で応答が拒否された場合に別のClaudeで再試行できる設定です。Anthropicの代替モデルの仕組み・FrontierCode-AA 2.0の結果と評価方法・Terminal-Bench 4.0の結果と評価方法
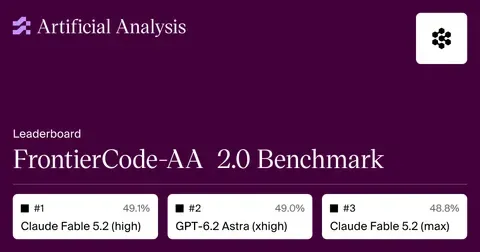
既存コードの改修なら、新Solは旧Astraからの乗り換え候補です。 FrontierCode-AA 2.0では、実際のオープンソースのリポジトリを題材に、132の変更がメンテナーの受け入れ条件をどこまで満たすかを採点します。新Solは旧Astraを2.0ポイント上回り、新Astraとの差も1.0ポイントでした。Opusは46.4%で新Astraを1.0ポイント上回り、今回の8モデルではFableに次ぐ2位でした。思考設定によって順位は動きます。たとえば新Astraをxhighにすると49.0%で、Fableのhigh(49.1%)に並ぶ水準です。AAの実装評価
OpenAIの発表にある「SolはAstraと0.5ポイント以内、費用は約5分の1」も、両モデルをmaxにしたFrontierCode 2.0の結果です。この記事のコード改修のグラフには、AAが独自の実行環境で再評価した値を使いました。どちらの集計でも2モデルは接近しています。OpenAIの公式比較・AAの実行条件
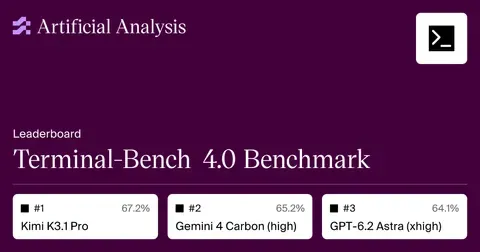
ターミナル作業では新Astraのリードが4.0ポイントに広がります。 Terminal-Bench 4.0は、ソフトウェアや運用などの66課題を対象に、各課題のテストをすべて通せた割合を測ります。新Astraの64.1%はCarbonの65.2%とSonnetの63.6%の間です。コマンドを試し、結果を読み、次の操作を選ぶ仕事が多いチームなら、この3モデルを自分たちの作業でも比べたいところです。AAのターミナル評価
業務資料では新Astraが伸び、Sonnetが首位を維持
「会議資料をまとめて、意思決定に使える報告書にして」と頼む場合、文章の滑らかさに加えて、必要な数値を拾えたか、結論を資料で裏づけられたかが重要です。AA-Briefcase v1.1は、メモ、表計算、プレゼン資料などを作る91課題を使い、要件への適合、分析の質、見せ方を合わせて評価します。Eloは成果物を比較して付ける相対的な点数です。AA-Briefcaseの採点方法
8モデルの総合Eloと95%信頼区間表開く表を開く閉じる
| モデル(思考設定) | 業務資料の総合Elo | 95%信頼区間 |
|---|---|---|
| Claude Sonnet 5.5(max) | 1,815 | 1,804〜1,827 |
| Claude Opus 5.5(max) | 1,800 | 1,790〜1,811 |
| Claude Fable 5.2(max) | 1,785 | 1,774〜1,796 |
| GPT-6.2 Astra(max) | 1,644 | 1,634〜1,655 |
| GPT-6.2 Sol(max) | 1,612 | 1,603〜1,623 |
| Gemini 4 Carbon(high) | 1,611 | 1,601〜1,622 |
| GPT-6 Astra(max) | 1,569 | 1,562〜1,578 |
| GPT-6.1 Sol(max) | 1,557 | 1,549〜1,566 |
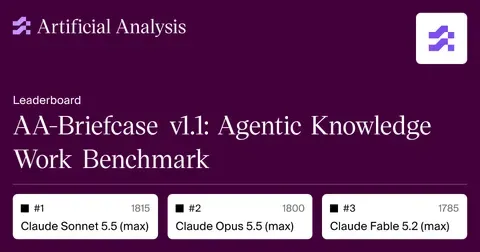
総合Eloと信頼区間は、11月18日の順位表に表示された整数値にそろえました。前世代からの伸びはAstraが75点、Solが55点です。新Solは旧Astraを43点上回り、Carbonとは1点差で信頼区間も重なります。Sonnetは新Solを203点上回りました。OpusはSonnetとFableのちょうど間で、どちらとも15点差です。Opusの95%信頼区間は両方と重なるため、この点差だけで報告書の仕上がりに優劣をつけるのは難しいでしょう。AA-Briefcaseの順位表
日本語で同じ解説を書くと、どこに差が出るか
業務資料の点数からは、「日本語で180字に収めて」「読み手が次にすることを一つ書いて」といった編集上の頼みにどう応えるかまでは分かりません。そこで、今回の発表を短くまとめた共通資料で試しました。GPTの4モデルにはCodex、Claudeの3モデルにはClaude Code、Gemini 4 CarbonにはGeminiアプリ付属のCLI(agy)で依頼しました。思考設定はすべてmediumで、各モデルが新しい会話で最初に返した原稿を掲載しています。
8モデルに渡した依頼と資料の全文原文 ・ 依頼文と発表資料開く全文を開く閉じる
次の発表資料だけを使い、AIを業務で使い始めた人向けに、2つのモデルの選び方を日本語で説明してください。見出し1行と本文120〜180字で、本文は1段落。両モデルの名前、評価の条件、数値、読み手が次にできることを含めてください。資料にない性能や日本語の優劣を補わず、外部検索やツールを使わずに答えてください。
発表資料:OpenAIは2026年11月17日、GPT-6.2 Astraを難しい仕事向け、GPT-6.2 Solを日常の仕事向けとして発表した。同社によると、既存のコードを改修するFrontierCode 2.0で、ともに思考設定をmaxにした場合、SolとAstraのスコア差は0.5ポイント以内で、Solの費用はAstraの約5分の1だった。この評価では日本語の文章は採点していない。
180字の上限に収まったのは8モデル中5モデル
破線は本文の上限180字です。指定は120〜180字。全モデルが下限を満たしており、棒が破線を越えた分だけ短くする必要があります。
- GPT-6.2 Astra188字
- GPT-6.2 Sol184字
- GPT-6 Astra169字
- GPT-6.1 Sol178字
- Claude Fable 5.2173字
- Claude Opus 5.5176字
- Claude Sonnet 5.5218字
- Gemini 4 Carbon172字
| モデル | 本文の字数(指定は120〜180字) | 編集者として気になった点 |
|---|---|---|
| GPT-6.2 Astra | 188字 | 用途をOpenAIの説明として紹介。「普段の文書」を使って試すところまで具体的。8字超過 |
| GPT-6.2 Sol | 184字 | 数字と条件は正確。冒頭の「Solが選ぶ目安です」は「Solが目安です」と直したい。4字超過 |
| GPT-6 Astra | 169字 | 比較条件と費用が字数内に収まる。「日本語文章は未評価です」は少し硬い |
| GPT-6.1 Sol | 178字 | 日本語が採点されていないことから、両方に同じ執筆依頼を出す提案へ自然につなぐ |
| Claude Fable 5.2 | 173字 | 「同社によると」で数値の出所を明示。末尾は日本語が未採点であることとSolを勧める理由のつながりが弱い |
| Claude Opus 5.5 | 176字 | 「同社によると」で数字の出所を示し、自分の業務で両方を試す提案まで収めた。「約5分の1」の比較相手は文中で補いたい |
| Claude Sonnet 5.5 | 218字 | Solで試し、不足を感じたらAstraと比べる順番が明快。発表日も入れ、38字超過 |
| Gemini 4 Carbon | 172字 | 日常業務でSolを試し、難しい仕事でAstraと比べる提案は具体的。「未採点のため」からSolを勧める理由は読み取りにくい |
字数は見出しと前後の空白を除き、本文中の空白・英数字・句読点を各1字として数えました。8本とも、比較条件のmax、0.5ポイント以内という差、約5分の1という費用を残しました。差が出たのは、その数字を読み手の行動にどう結びつけたかです。
たとえば新Astraの結びは「普段の文書を題材に両方を試し、仕上がりを比べてみましょう」。コードの評価しかない資料から、日本語の優劣を言い切らず、読み手が確かめる方法を示しています。旧Solも同じ考え方を178字に収めました。今回の1本に限れば、字数が厳密な記事欄には旧Solの原稿のほうがそのまま載せやすい、というのが筆者の判断です。
8モデルの見出しと本文読み比べ開く開く閉じる
GPT-6.2 Astra
日常の仕事はSol、難しい仕事はAstraから試す
OpenAIはGPT-6.2 Solを日常の仕事向け、GPT-6.2 Astraを難しい仕事向けとしています。既存のコードを改修するFrontierCode 2.0では、両モデルの思考設定をmaxにすると、スコア差は0.5ポイント以内で、Solの費用はAstraの約5分の1でした。日本語の文章は採点されていないため、普段の文書を題材に両方を試し、仕上がりを比べてみましょう。
GPT-6.2 Sol
仕事に合わせた2つのモデルの選び方
難しい仕事にはGPT-6.2 Astra、日常の仕事にはGPT-6.2 Solが選ぶ目安です。既存コードを改修するFrontierCode 2.0では、両方の思考設定をmaxにすると、スコア差は0.5ポイント以内で、Solの費用はAstraの約5分の1でした。日本語の文章は採点対象外でした。まずは手元の仕事を一つ選び、用途に合うモデルで試して、出力を確認しましょう。
GPT-6 Astra
日常業務はSol、難しい仕事はAstraを目安に
GPT-6.2 Solは日常の仕事向け、GPT-6.2 Astraは難しい仕事向けです。既存コードを改修するFrontierCode 2.0で、ともに思考設定maxの評価では、スコア差は0.5ポイント以内、Solの費用はAstraの約5分の1でした。日本語文章は未評価です。まず自分の業務の同じ課題を両方で試し、結果と費用を比べましょう。
GPT-6.1 Sol
仕事の難しさで選ぶGPT-6.2 AstraとGPT-6.2 Sol
日常の仕事はGPT-6.2 Sol、難しい仕事はGPT-6.2 Astraを候補にしましょう。既存コードを改修するFrontierCode 2.0では、両モデルの思考設定をmaxにすると、スコア差は0.5ポイント以内で、Solの費用はAstraの約5分の1でした。日本語の文章は採点されていないので、文章作成に使うなら、同じ依頼を両方に出して比べましょう。
Claude Fable 5.2
日常業務はSolから、難しい仕事はAstraを検討
OpenAIはGPT-6.2 Astraを難しい仕事向け、GPT-6.2 Solを日常の仕事向けとしています。同社によると、既存コードを改修するFrontierCode 2.0で思考設定をともにmaxにした場合、スコア差は0.5ポイント以内、Solの費用はAstraの約5分の1でした。日本語の文章は未採点のため、まずSolを業務で試しましょう。
Claude Opus 5.5
日常業務はGPT-6.2 Solから試す選択肢も
OpenAIは日常の仕事向けにGPT-6.2 Sol、難しい仕事向けにGPT-6.2 Astraを発表した。同社によると、既存コードを改修するFrontierCode 2.0で両方の思考設定をmaxにした場合、スコア差は0.5ポイント以内、Solの費用は約5分の1だった。日本語の文章は採点外なので、自分の業務でSolを試し、Astraと比べてみよう。
Claude Sonnet 5.5
まずは日常業務ならGPT-6.2 Solから試す
OpenAIは2026年11月17日、難しい仕事向けのGPT-6.2 Astraと日常の仕事向けのGPT-6.2 Solを発表しました。既存コードを改修するFrontierCode 2.0で、ともに思考設定をmaxにした場合、両者のスコア差は0.5ポイント以内で、Solの費用はAstraの約5分の1でした。ただしこの評価は日本語の文章を採点していません。まず自分の業務の題材でSolを試し、不足を感じた場合にAstraを比べましょう。
Gemini 4 Carbon
日常業務はGPT-6.2 Solから試し、難しい仕事でAstraと比較を
日常の仕事向けのGPT-6.2 Solと難しい仕事向けのGPT-6.2 Astraは、既存コードを改修するFrontierCode 2.0で思考設定をともにmaxにした場合、スコア差は0.5ポイント以内でSolの費用はAstraの約5分の1です。日本語の文章は未採点のため、まずは日常業務をSolで試し、難しい仕事でAstraと比較しましょう。
料金は、同じ仕事を終えるまでいくらか
APIの入出力単価が同じでも、モデルが読み書きするトークン量やキャッシュの使い方で費用は変わります。次の表の右端は、AAが9つの評価を合わせたIntelligence Index v5.0.1で算出した1タスクあたりの費用です。上の日本語原稿1本の料金とは対象が異なります。
同じ評価で、新Solは1タスクあたり1.01ドル
AAのIntelligence Index v5.0.1の9評価から算出した加重平均費用です。棒が短いほど1タスクあたりの費用が低くなります。
- GPT-6.2 Sol$1.01
- GPT-6.1 Sol$1.27
- GPT-6.2 Astra$4.00
- Gemini 4 Carbon$5.48
- GPT-6 Astra$6.24
- Claude Sonnet 5.5$10.02
- Claude Opus 5.5$10.04
- Claude Fable 5.2$26.54
| モデル | 標準入力/100万トークン | 標準出力/100万トークン | AAの1タスクあたりの費用 |
|---|---|---|---|
| GPT-6.2 Astra(max) | $8 | $40 | $4.00 |
| GPT-6.2 Sol(max) | $2 | $10 | $1.01 |
| GPT-6 Astra(max) | $10 | $50 | $6.24 |
| GPT-6.1 Sol(max) | $2 | $10 | $1.27 |
| Claude Fable 5.2(max) | $8 | $40 | $26.54 |
| Claude Opus 5.5(max) | $4 | $20 | $10.04 |
| Claude Sonnet 5.5(max) | $2 | $10 | $10.02 |
| Gemini 4 Carbon(high) | $2 | $10 | $5.48 |
表は米ドルで、入力はキャッシュを使わない場合の単価です。Opusの入出力単価はSonnetの2倍ですが、AAが測った1タスクの費用はOpusが10.04ドル、Sonnetが10.02ドルで、差は2セントでした。Anthropicの標準料金・Opusの実行費用
新SolとSonnetはいずれも入力2ドル・出力10ドルですが、新Solは1回の入力が27万2,000トークンを超えると、そのリクエスト全体で入力単価が2倍、出力単価が1.5倍になります。Sonnetは100万トークンのコンテキスト全体で通常単価です。新Solの長文料金・Claudeの長文料金
Carbonは11月末までの導入価格で、12月1日から入力4ドル・出力20ドルの予定です。右端のAAの費用には評価時のキャッシュ利用も反映されています。OpenAIの新モデル料金・旧Astraの料金・Geminiの料金
AAのモデル別内訳:新Astra・新Sol・旧Astra・旧Sol・Fable・Opus・Sonnet・Carbon
新Solは旧Astraより、今回の実装・ターミナル・資料作成の3評価すべてで高い値を出しました。AAの9評価を重み付けした1タスクあたりの平均費用は、新Solが旧Astraの約6分の1、Sonnetの約10分の1です。報告書にSonnetを使うなら、提出できる原稿に整えるまでの修正時間がどれだけ減るかも併せて見ると、選びやすくなります。
普段はSol、切り替え先は仕事で決める
旧Astraで定型的なコード改修を回しているなら、最初の候補は新Solです。直近で終えた修正を一つ選び、同じ仕様とテストを渡せば、レビューで人が直す箇所まで比べられます。ターミナルでの試行錯誤が続く仕事なら新AstraやCarbonを、根拠をそろえた業務資料ならSonnetを比較相手にできます。
短い日本語の原稿で指定の字数に収めたのは、旧Astra、旧Sol、Fable、Opus、Carbonの5モデルです。旧Solは同じ執筆依頼を両方に出す提案を178字に、Carbonは日常業務と難しい仕事で試し方を変える提案を172字に収めました。新Astraの「普段の文書を題材に」という提案も具体的ですが、掲載には8字削る必要があります。「180字の紹介欄にそのまま入る」「読み終えた人が次に何をするか分かる」。そんな採用条件を一つ決めて、普段の原稿を渡してみてください。
参考資料
この記事は、次の一次情報に基づいています。数値や記述の詳細は各資料をご確認ください。
参考資料 8 件を表示参考資料を閉じる
- GPT-6.2 Astraの評価と費用Artificial Analysisartificialanalysis.ai確認
- GPT-6.2 Solの評価と費用Artificial Analysisartificialanalysis.ai確認
- Claude APIの料金表Anthropicplatform.claude.com確認
この記事を引用する
岡崎 太「GPT-6.2 AstraとSol、コードと文章でどう選ぶ? 8モデルを比較」株式会社フィールフロウ、2026年11月18日、https://feelflow.net/blog/2026-11-gpt-6-2-astra-sol-comparison/
この記事を書いた人
岡崎 太
CTO / AIアーキテクト