AIに丁寧なレビューを頼むほど、確認事項が増え、ひとつの作業が終わらなくなる。AI駆動開発を続けるなかで、私たちもこの問題に向き合ってきました。
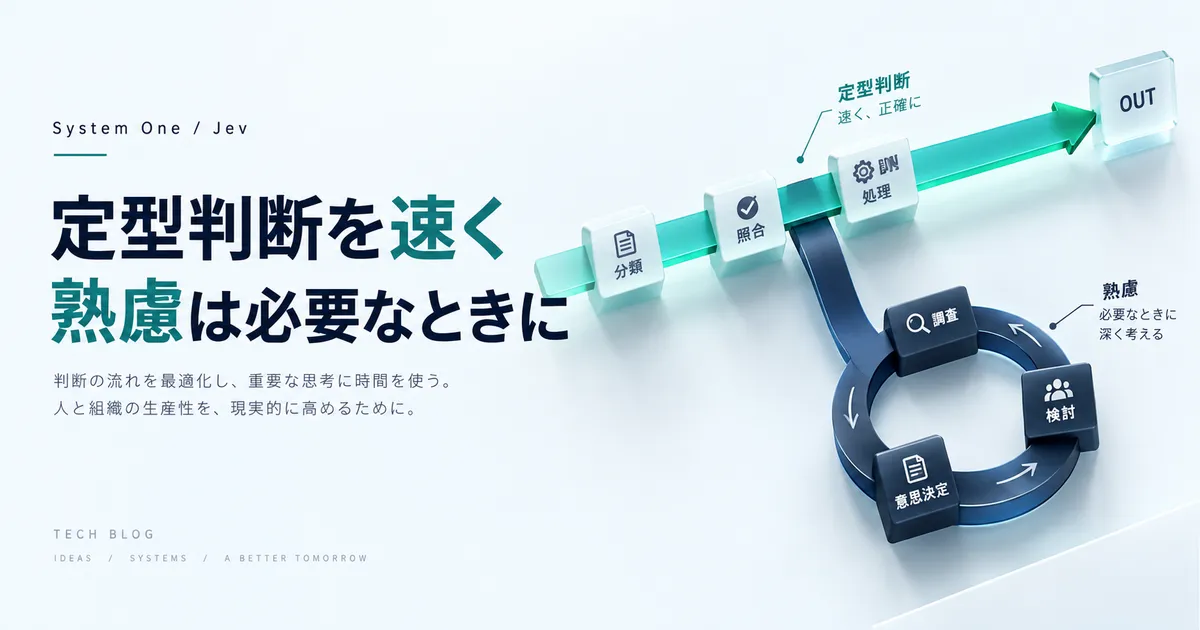
そこで目に留まったのが、TypeSafe AIが2026年9月15日に発表した「System One Models」と、最初のモデル「Jev」です。文章を生成することより、ソフトウェアが使う判断を返すことに特化しています。公式発表を読み、私が自社の開発に取り込んだのは、定型判断を短い経路で終え、必要な場面に熟慮を集中するという考え方でした。
本記事はJevの導入実績や性能検証の報告ではありません。公開情報の確認と、それをきっかけに見直した開発運用について、CTOの立場から整理します。情報の確認日は2026年9月19日です。
Jevは何を返すモデルなのか
Jevには、判断対象の状態である state と、型を指定した質問を渡します。返るのは自由な文章ではなく、コードから扱える値です。公式ドキュメントは、次の3つを基本部品(プリミティブ)としています。
| 型 | 問うこと | 返るもの | 用途の例 |
|---|---|---|---|
| Choice | 用意した候補のどれか | 選択結果・候補ごとの確率・confidence | 問い合わせの担当部署 |
| Score | 定義した段階のどの位置か | スコア・段階の定義・確率・confidence | 障害の深刻度 |
| Noul | 命題が真か | 真である確率を表す0〜1の値 | 返金を求めているか |
Scoreは段階の間の値も返します。また、Noulには独立した confidence フィールドがありません。「すべての回答に同じ信頼度フィールドが付く」と理解すると、実装を取り違えます。
複数の質問は同じ状態に対して独立に評価されます。前の答えを次の判断の材料にする必要があれば、コード側で次の呼び出しを組み立てます。判断を小さく分け、結果をどう組み合わせるかをソフトウェア側に残す構成です。
RLCDと、即断・熟慮の分担
TypeSafeは、学習手法を RLCD(Reinforcement Learning for Calibrated Decisions) と呼んでいます。判断と、その不確実性を扱うことを狙った方式です。System Oneという名前は、Daniel Kahnemanの著書にある、速い直感的なSystem 1と、時間をかけるSystem 2の区別に着想を得ています。これは製品の命名と設計上の比喩であり、人間の認知機構を再現したという証明ではありません。
実装上の分担は分かりやすく、狭く定義した質問を判断する部分と、複数の条件を検討して計画する部分を分けることです。公式のIntroductionも、長い推論を要する問いは分解し、答えをコードで組み合わせるよう勧めています。
confidenceは正解保証ではない
Confidenceの仕様によれば、ChoiceとScoreの confidence は確率分布の形を要約した値です。「0.9だから、この1件が90%の確率で正しい」とそのまま読み替えるものではありません。
たとえば担当部署を選ぶ場合、部署ごとの確率が拮抗していれば、人に戻す経路を用意できます。ただし、閾値は業務データで検証して決める必要があります。高いconfidenceだけで、権限確認や実行前の承認を置き換えられるわけでもありません。
国内記事を読むときに補いたい6点
Think Twiceの解説やGIGAZINEの記事は、Jevを知る入口になります。一方で、見出しや要約から実装の判断へ進むときは、次の条件を補って読むと誤解を避けられます。媒体全体の評価ではなく、個々の表現と一次情報の対応を整理したものです。
| 表現・論点 | 確認結果と読み方 |
|---|---|
| 「ChatGPT共同開発者」 | 元OpenAI研究者で、InstructGPT論文の共著者であることは確認できます。TypeSafe側にもChatGPTの共同発明者という紹介がありますが、担当範囲が伝わる「InstructGPT論文共著者」とするのが具体的です。 |
| 「20〜200倍高速」 | 公式発表の表記は40〜200倍、応答時間70〜500msです。System One型の質問におけるベンダーの比較値であり、全用途の速度保証ではありません。 |
| 「GPT-5.6 Terra級の精度を100分の1のコストで」 | System Oneタスクという条件付きです。公式サイトの238倍はClaude Fable 5.1との入力単価比、444.6倍はワークフロー評価の費用比で、測っているものが違います。 |
| 「確率と現実が完全に一致する」 | 較正を目指す設計と、あらゆる入力で予測が完全に一致する保証は別です。confidenceの仕様も正答率そのものではありません。 |
| 「ハルシネーションを排除」 | TypeSafeが保証として説明するのは、出力が指定した型・候補を外れないことです。候補のなかから誤った答えを選ぶ可能性は残ります。 |
| 「Context-rotを完全排除」 | 発表ブログだけでは裏付けられません。ただし確認日時点の公式Introductionには、質問を独立評価するため質問追加でcontext-rotが生じないという説明があります。長い入力や不適切な状態まで含む、文脈劣化全般の排除とは読めません。 |
人物の経歴はInstructGPT論文、速度・比較条件・型保証は公式発表、入力単価比は公式サイト、confidenceは仕様、Context-rotの記述はIntroductionで確認できます。
費用比較には、もう一段留保が必要です。公式のワークフロー評価は、人間が確定した正解への一致率ではなく、GPT-6 AstraとFable 5.1の平均的な予測を参照しています。評価は自社チームによるもので、公開情報を確認した範囲では、性能主張を独立に検証したベンチマークは確認できませんでした。私たちも追試していません。
一次情報と一致する3点
次の点は、発表時点の公式情報と一致します。
- 料金:入力100万トークン当たり0.042米ドル、出力は無料と公表されています。ワークフロー全体の運用費とは区別が必要です。
- DOOMのデモ:毎秒10回の問い合わせで約7米ドル/時という説明です。画面の画像を読むデモではなく、テキストで表した構造化状態を入力しています。
- 二重過程理論からの着想:System 1とSystem 2の区別を命名の由来として挙げています。
TypeSafeは2年間の開発を経て発表したと説明し、BusinessWireの同社発表ではDCVC主導のシード資金4,000万米ドルを公表しています。資金調達額は性能の検証結果ではありません。
提供状況も日付で分けて読む必要があります。9月15日の発表では early access で、公式サイトには確認日時点でも待機リストがあります。一方、Vercelは9月16日にAI GatewayでのJev提供を発表しています。「待機リスト経由でしか利用できない」とは言い切れませんが、これを根拠にTypeSafe直販APIの一般提供を断定することもできません。
CTOとして、自社の開発運用へ取り込んだこと
私たちの課題は、精度を上げようとするほど規定・検査・対策が増え、ひとつのタスクが膨れて収束しなくなることでした。対策済みの問題が再発したときに、同じ種類の注意書きを追加する。それを守らせるために、さらに確認項目を足す。この繰り返しでは、判断の負担自体が増えてしまいます。
そこで自社の開発ツールキットの運用原則を更新しました。取り込んだのは、次の3点です。Jevを開発フローへ接続したわけではなく、既存のAIエージェントに対する指示と判断の進め方を改めています。
1. 定型判断は、既存の表を適用して終える
重大度の分類、作業範囲、レビューの深さ、承認の要否など、すでに判断表があるものは毎回議論し直しません。
たとえば文書の誤字修正なら、まず変更内容を既存の検証区分へ当てはめます。そこで必要とされた検証を行い、新しい不具合の兆候がなければ、追加の検査を際限なく考案することはしません。表の判定そのものに新しい矛盾が見つかった場合は、次の熟慮の経路へ移します。
2. 熟慮を始める条件を、観測できる出来事にする
「心配だからもう一度考える」では終わりがありません。テストが失敗した、具体的な失敗シナリオが示された、対策済みの問題が再発した、といった検知できる条件を起点にします。
自社では分散していた既存の判断規定への参照を、ひとつの節に集めました。本文をあちこちへ複製するのでなく、どの条件でどの規定を見るかを辿れるようにしています。
とくに、対策を完了したはずの問題が再発した場合は、前と同じ種類の注意書きや参照先の追加を繰り返さず、構造を変える案を検討する方針にしました。有効な案がなければ、観測を記録して終える。新しい対策を提案すること自体を目的にしないためです。
3. 規定は上位の原則で書き、導けない事実を具体に残す
すべての場面の手順を列挙するほど、読む量も整合を保つ手間も増えます。目的と判断の原則から推論できることは、その原則で伝えるようにしました。
一方、特定の環境だけで起きるツールの挙動や、実測で直感が外れた事実は具体的に残します。「何でも抽象化する」のではなく、推論だけでは分からない情報を残すという境界です。繰り返し誤る判断については、注意文を増やすより機械的に検査できる形への移行を検討します。
これらは運用規定へ反映済みですが、作業時間や手戻りの削減効果はまだ定量評価していません。ここで報告できるのは、運用を変えたことまでです。
導入判断と、今日変えられる運用を分ける
Jevは、文章を生成する以外のAIの使い方を考えるきっかけになります。ただし、速度や価格だけを見て導入を推奨する段階ではありません。対象業務の入力で判断が合うか、不確かなときに適切に止まれるかを確かめる必要があります。
私たちが先に変えたのは、どこに考える時間を使うかです。既存の判断表で済む仕事を短く終え、失敗や矛盾が観測されたところで立ち止まる。その区別は、使うモデルにかかわらず、開発チームで見直せます。
AI駆動開発のルールやレビューが増え続けているなら、次の規定を足す前に、「この判断を毎回考え直す必要があるか」を問い直してみてはいかがでしょうか。
参考資料
- TypeSafe AI:Introducing System One Models & Jev(2026年9月15日)
- TypeSafe AI:公式サイト/Introduction/Primitives/Confidence
- Ouyangほか:Training language models to follow instructions with human feedback(InstructGPT論文、2022年)
- TypeSafe AI/BusinessWire:TypeSafe AI Emerges From Stealth With $40M in Funding With New Model for Composable AI(2026年9月15日。配信記事の転載でも確認)
- Vercel:TypeSafe AI’s Jev now available on AI Gateway(2026年9月16日)
- GIGAZINE:JevとSystem One Modelsの紹介記事(2026年9月16日)
- The Register:TypeSafe AI debuts model for machines that plays Doom(2026年9月16日)
- Think Twice:JevとSystem One Modelsの解説(2026年9月17日公開、確認時点で9月19日更新)